Go语言圣经(中文版)读书笔记
重要
Go 语言圣经(中文版)链接:https://gopl-zh.github.io/index.html
Go 标准库:https://pkg.go.dev/std
Go 库:https://pkg.go.dev/std
2.1. 命名
重要
如果一个名字是在函数内部定义,那么它就只在函数内部有效。如果是在函数外部定义,那么将在当前包的所有文件中都可以访问。
名字的开头字母的大小写决定了名字在包外的可见性。如果一个名字是大写字母开头的,那么它可以被外部的包访问,例如fmt包的Printf函数就是导出的,可以在fmt包外部访问。
包本身的名字一般总是用小写字母
Go语言中的函数名、变量名、常量名、类型名、语句标号和包名等所有的命名,都遵循一个简单的命名规则:一个名字必须以一个字母(Unicode字母)或下划线开头,后面可以跟任意数量的字母、数字或下划线。大写字母和小写字母是不同的:heapSort和Heapsort是两个不同的名字。
Go语言中类似if和switch的关键字有25个;关键字不能用于自定义名字,只能在特定语法结构中使用。
break      default       func     interface   select
case       defer         go       map         struct
chan       else          goto     package     switch
const      fallthrough   if       range       type
continue   for           import   return      var
此外,还有大约30多个预定义的名字,比如int和true等,主要对应内建的常量、类型和函数。
内建常量: true false iota nil

内建类型: int int8 int16 int32 int64
          uint uint8 uint16 uint32 uint64 uintptr
          float32 float64 complex128 complex64
          bool byte rune string error

内建函数: make len cap new append copy close delete
          complex real imag
          panic recover
这些内部预先定义的名字并不是关键字,你可以在定义中重新使用它们。在一些特殊的场景中重新定义它们也是有意义的,但是也要注意避免过度而引起语义混乱。
注意
如果一个名字是在函数内部定义,那么它就只在函数内部有效。如果是在函数外部定义,那么将在当前包的所有文件中都可以访问。名字的开头字母的大小写决定了名字在包外的可见性。如果一个名字是大写字母开头的(译注:必须是在函数外部定义的包级名字;包级函数名本身也是包级名字),那么它将是导出的,也就是说可以被外部的包访问,例如fmt包的Printf函数就是导出的,可以在fmt包外部访问。包本身的名字一般总是用小写字母。
名字的长度没有逻辑限制,但是Go语言的风格是尽量使用短小的名字,对于局部变量尤其是这样;你会经常看到i之类的短名字,而不是冗长的theLoopIndex命名。通常来说,如果一个名字的作用域比较大,生命周期也比较长,那么用长的名字将会更有意义。
在习惯上,Go语言程序员推荐使用 驼峰式 命名,当名字由几个单词组成时优先使用大小写分隔,而不是优先用下划线分隔。因此,在标准库有QuoteRuneToASCII和parseRequestLine这样的函数命名,但是一般不会用quote_rune_to_ASCII和parse_request_line这样的命名。而像ASCII和HTML这样的缩略词则避免使用大小写混合的写法,它们可能被称为htmlEscape、HTMLEscape或escapeHTML,但不会是escapeHtml。
2.2. 声明
重要
- Go语言主要有四种类型的声明语句:var、const、type和func,分别对应变量、常量、类型和函数实体对象的声明
- 在包一级声明语句声明的名字可在整个包对应的每个源文件中访问,而不是仅仅在其声明语句所在的源文件中访问
- 包一级的各种类型的声明语句的顺序无关紧要(译注:函数内部的名字则必须先声明之后才能使用)
声明语句定义了程序的各种实体对象以及部分或全部的属性。Go语言主要有四种类型的声明语句:var、const、type和func,分别对应变量、常量、类型和函数实体对象的声明。这一章我们重点讨论变量和类型的声明,第三章将讨论常量的声明,第五章将讨论函数的声明。
一个Go语言编写的程序对应一个或多个以.go为文件后缀名的源文件。每个源文件中以包的声明语句开始,说明该源文件是属于哪个包。包声明语句之后是import语句导入依赖的其它包,然后是包一级的类型、变量、常量、函数的声明语句,包一级的各种类型的声明语句的顺序无关紧要(译注:函数内部的名字则必须先声明之后才能使用)。例如,下面的例子中声明了一个常量、一个函数和两个变量:
// Boiling prints the boiling point of water.
package main

import "fmt"

const boilingF = 212.0

func main() {
	var f = boilingF
	var c = (f - 32) * 5 / 9
	fmt.Printf("boiling point = %g°F or %g°C\n", f, c)
	// Output:
	// boiling point = 212°F or 100°C
}
其中常量boilingF是在包一级范围声明语句声明的,然后f和c两个变量是在main函数内部声明的声明语句声明的。在包一级声明语句声明的名字可在整个包对应的每个源文件中访问,而不是仅仅在其声明语句所在的源文件中访问。相比之下,局部声明的名字就只能在函数内部很小的范围被访问。
一个函数的声明由一个函数名字、参数列表(由函数的调用者提供参数变量的具体值)、一个可选的返回值列表和包含函数定义的函数体组成。如果函数没有返回值,那么返回值列表是省略的。执行函数从函数的第一个语句开始,依次顺序执行直到遇到return返回语句,如果没有返回语句则是执行到函数末尾,然后返回到函数调用者。
我们已经看到过很多函数声明和函数调用的例子了,在第五章将深入讨论函数的相关细节,这里只简单解释下。下面的fToC函数封装了温度转换的处理逻辑,这样它只需要被定义一次,就可以在多个地方多次被使用。在这个例子中,main函数就调用了两次fToC函数,分别使用在局部定义的两个常量作为调用函数的参数。
// Ftoc prints two Fahrenheit-to-Celsius conversions.
package main

import "fmt"

func main() {
	const freezingF, boilingF = 32.0, 212.0
	fmt.Printf("%g°F = %g°C\n", freezingF, fToC(freezingF)) // "32°F = 0°C"
	fmt.Printf("%g°F = %g°C\n", boilingF, fToC(boilingF))   // "212°F = 100°C"
}

func fToC(f float64) float64 {
	return (f - 32) * 5 / 9
}
2.3. 变量
var声明语句可以创建一个特定类型的变量,然后给变量附加一个名字,并且设置变量的初始值。变量声明的一般语法如下:
var 变量名字 类型 = 表达式其中“类型”或“= 表达式”两个部分可以省略其中的一个。如果省略的是类型信息,那么将根据初始化表达式来推导变量的类型信息。如果初始化表达式被省略,那么将用零值初始化该变量。 数值类型变量对应的零值是0,布尔类型变量对应的零值是false,字符串类型对应的零值是空字符串,接口或引用类型(包括slice、指针、map、chan和函数)变量对应的零值是nil。数组或结构体等聚合类型对应的零值是每个元素或字段都是对应该类型的零值。
零值初始化机制可以确保每个声明的变量总是有一个良好定义的值,因此在Go语言中不存在未初始化的变量。这个特性可以简化很多代码,而且可以在没有增加额外工作的前提下确保边界条件下的合理行为。例如:
var s string
fmt.Println(s) // ""
这段代码将打印一个空字符串,而不是导致错误或产生不可预知的行为。Go语言程序员应该让一些聚合类型的零值也具有意义,这样可以保证不管任何类型的变量总是有一个合理有效的零值状态。
也可以在一个声明语句中同时声明一组变量,或用一组初始化表达式声明并初始化一组变量。如果省略每个变量的类型,将可以声明多个类型不同的变量(类型由初始化表达式推导):
var i, j, k int                 // int, int, int
var b, f, s = true, 2.3, "four" // bool, float64, string
初始化表达式可以是字面量或任意的表达式。在包级别声明的变量会在main入口函数执行前完成初始化(§2.6.2),局部变量将在声明语句被执行到的时候完成初始化。
一组变量也可以通过调用一个函数,由函数返回的多个返回值初始化:
var f, err = os.Open(name) // os.Open returns a file and an error2.3.1. 简短变量声明
在函数内部,有一种称为简短变量声明语句的形式可用于声明和初始化局部变量。它以“名字 := 表达式”形式声明变量,变量的类型根据表达式来自动推导。下面是lissajous函数中的三个简短变量声明语句(§1.4):
anim := gif.GIF{LoopCount: nframes}
freq := rand.Float64() * 3.0
t := 0.0
因为简洁和灵活的特点,简短变量声明被广泛用于大部分的局部变量的声明和初始化。var形式的声明语句往往是用于需要显式指定变量类型的地方,或者因为变量稍后会被重新赋值而初始值无关紧要的地方。
i := 100                  // an int
var boiling float64 = 100 // a float64
var names []string
var err error
var p Point
和var形式声明语句一样,简短变量声明语句也可以用来声明和初始化一组变量:
i, j := 0, 1但是这种同时声明多个变量的方式应该限制只在可以提高代码可读性的地方使用,比如for语句的循环的初始化语句部分。
请记住“:=”是一个变量声明语句,而“=”是一个变量赋值操作。也不要混淆多个变量的声明和元组的多重赋值(§2.4.1),后者是将右边各个表达式的值赋值给左边对应位置的各个变量:
i, j = j, i // 交换 i 和 j 的值和普通var形式的变量声明语句一样,简短变量声明语句也可以用函数的返回值来声明和初始化变量,像下面的os.Open函数调用将返回两个值:
f, err := os.Open(name)
if err != nil {
	return err
}
// ...use f...
f.Close()
这里有一个比较微妙的地方:简短变量声明左边的变量可能并不是全部都是刚刚声明的。如果有一些已经在相同的词法域声明过了(§2.7),那么简短变量声明语句对这些已经声明过的变量就只有赋值行为了。
在下面的代码中,第一个语句声明了in和err两个变量。在第二个语句只声明了out一个变量,然后对已经声明的err进行了赋值操作。
in, err := os.Open(infile)
// ...
out, err := os.Create(outfile)
简短变量声明语句中必须至少要声明一个新的变量,下面的代码将不能编译通过:
f, err := os.Open(infile)
// ...
f, err := os.Create(outfile) // compile error: no new variables
解决的方法是第二个简短变量声明语句改用普通的多重赋值语句。
简短变量声明语句只有对已经在同级词法域声明过的变量才和赋值操作语句等价,如果变量是在外部词法域声明的,那么简短变量声明语句将会在当前词法域重新声明一个新的变量。我们在本章后面将会看到类似的例子。
2.3.2. 指针
一个变量对应一个保存了变量对应类型值的内存空间。普通变量在声明语句创建时被绑定到一个变量名,比如叫x的变量,但是还有很多变量始终以表达式方式引入,例如x[i]或x.f变量。所有这些表达式一般都是读取一个变量的值,除非它们是出现在赋值语句的左边,这种时候是给对应变量赋予一个新的值。
一个指针的值是另一个变量的地址。一个指针对应变量在内存中的存储位置。并不是每一个值都会有一个内存地址,但是对于每一个变量必然有对应的内存地址。通过指针,我们可以直接读或更新对应变量的值,而不需要知道该变量的名字(如果变量有名字的话)。
如果用“var x int”声明语句声明一个x变量,那么&x表达式(取x变量的内存地址)将产生一个指向该整数变量的指针,指针对应的数据类型是*int,指针被称之为“指向int类型的指针”。如果指针名字为p,那么可以说“p指针指向变量x”,或者说“p指针保存了x变量的内存地址”。同时*p表达式对应p指针指向的变量的值。一般*p表达式读取指针指向的变量的值,这里为int类型的值,同时因为*p对应一个变量,所以该表达式也可以出现在赋值语句的左边,表示更新指针所指向的变量的值。
x := 1
p := &x         // p, of type *int, points to x
fmt.Println(*p) // "1"
*p = 2          // equivalent to x = 2
fmt.Println(x)  // "2"
对于聚合类型每个成员——比如结构体的每个字段、或者是数组的每个元素——也都是对应一个变量,因此可以被取地址。
变量有时候被称为可寻址的值。即使变量由表达式临时生成,那么表达式也必须能接受&取地址操作。
任何类型的指针的零值都是nil。如果p指向某个有效变量,那么p != nil测试为真。指针之间也是可以进行相等测试的,只有当它们指向同一个变量或全部是nil时才相等。
var x, y int
fmt.Println(&x == &x, &x == &y, &x == nil) // "true false false"
在Go语言中,返回函数中局部变量的地址也是安全的。例如下面的代码,调用f函数时创建局部变量v,在局部变量地址被返回之后依然有效,因为指针p依然引用这个变量。
var p = f()

func f() *int {
	v := 1
	return &v
}
每次调用f函数都将返回不同的结果:
fmt.Println(f() == f()) // "false"因为指针包含了一个变量的地址,因此如果将指针作为参数调用函数,那将可以在函数中通过该指针来更新变量的值。例如下面这个例子就是通过指针来更新变量的值,然后返回更新后的值,可用在一个表达式中(译注:这是对C语言中++v操作的模拟,这里只是为了说明指针的用法,incr函数模拟的做法并不推荐):
func incr(p *int) int {
	*p++ // 非常重要:只是增加p指向的变量的值,并不改变p指针!!!
	return *p
}

v := 1
incr(&v)              // side effect: v is now 2
fmt.Println(incr(&v)) // "3" (and v is 3)每次我们对一个变量取地址,或者复制指针,我们都是为原变量创建了新的别名。例如,*p就是变量v的别名。指针特别有价值的地方在于我们可以不用名字而访问一个变量,但是这是一把双刃剑:要找到一个变量的所有访问者并不容易,我们必须知道变量全部的别名(译注:这是Go语言的垃圾回收器所做的工作)。不仅仅是指针会创建别名,很多其他引用类型也会创建别名,例如slice、map和chan,甚至结构体、数组和接口都会创建所引用变量的别名。
指针是实现标准库中flag包的关键技术,它使用命令行参数来设置对应变量的值,而这些对应命令行标志参数的变量可能会零散分布在整个程序中。为了说明这一点,在早些的echo版本中,就包含了两个可选的命令行参数:-n用于忽略行尾的换行符,-s sep用于指定分隔字符(默认是空格)。下面这是第四个版本,对应包路径为gopl.io/ch2/echo4。
// Echo4 prints its command-line arguments.
package main

import (
	"flag"
	"fmt"
	"strings"
)

var n = flag.Bool("n", false, "omit trailing newline")
var sep = flag.String("s", " ", "separator")

func main() {
	flag.Parse()
	fmt.Print(strings.Join(flag.Args(), *sep))
	if !*n {
		fmt.Println()
	}
}调用flag.Bool函数会创建一个新的对应布尔型标志参数的变量。它有三个属性:第一个是命令行标志参数的名字“n”,然后是该标志参数的默认值(这里是false),最后是该标志参数对应的描述信息。如果用户在命令行输入了一个无效的标志参数,或者输入-h或-help参数,那么将打印所有标志参数的名字、默认值和描述信息。类似的,调用flag.String函数将创建一个对应字符串类型的标志参数变量,同样包含命令行标志参数对应的参数名、默认值、和描述信息。程序中的sep和n变量分别是指向对应命令行标志参数变量的指针,因此必须用*sep和*n形式的指针语法间接引用它们。
当程序运行时,必须在使用标志参数对应的变量之前先调用flag.Parse函数,用于更新每个标志参数对应变量的值(之前是默认值)。对于非标志参数的普通命令行参数可以通过调用flag.Args()函数来访问,返回值对应一个字符串类型的slice。如果在flag.Parse函数解析命令行参数时遇到错误,默认将打印相关的提示信息,然后调用os.Exit(2)终止程序。
让我们运行一些echo测试用例:
$ go build gopl.io/ch2/echo4
$ ./echo4 a bc def
a bc def
$ ./echo4 -s / a bc def
a/bc/def
$ ./echo4 -n a bc def
a bc def$
$ ./echo4 -help
Usage of ./echo4:
  -n    omit trailing newline
  -s string
        separator (default " ")
2.3.3. new函数
另一个创建变量的方法是调用内建的new函数。表达式new(T)将创建一个T类型的匿名变量,初始化为T类型的零值,然后返回变量地址,返回的指针类型为*T。
p := new(int)   // p, *int 类型, 指向匿名的 int 变量
fmt.Println(*p) // "0"
*p = 2          // 设置 int 匿名变量的值为 2
fmt.Println(*p) // "2"
用new创建变量和普通变量声明语句方式创建变量没有什么区别,除了不需要声明一个临时变量的名字外,我们还可以在表达式中使用new(T)。换言之,new函数类似是一种语法糖,而不是一个新的基础概念。
下面的两个newInt函数有着相同的行为:
func newInt() *int {
	return new(int)
}

func newInt() *int {
	var dummy int
	return &dummy
}
每次调用new函数都是返回一个新的变量的地址,因此下面两个地址是不同的:
p := new(int)
q := new(int)
fmt.Println(p == q) // "false"当然也可能有特殊情况:如果两个类型都是空的,也就是说类型的大小是0,例如struct{}和[0]int,有可能有相同的地址(依赖具体的语言实现)(译注:请谨慎使用大小为0的类型,因为如果类型的大小为0的话,可能导致Go语言的自动垃圾回收器有不同的行为,具体请查看runtime.SetFinalizer函数相关文档)。
new函数使用通常相对比较少,因为对于结构体来说,直接用字面量语法创建新变量的方法会更灵活(§4.4.1)。
由于new只是一个预定义的函数,它并不是一个关键字,因此我们可以将new名字重新定义为别的类型。例如下面的例子:
func delta(old, new int) int { return new - old }由于new被定义为int类型的变量名,因此在delta函数内部是无法使用内置的new函数的。
2.3.4. 变量的生命周期
变量的生命周期指的是在程序运行期间变量有效存在的时间段。对于在包一级声明的变量来说,它们的生命周期和整个程序的运行周期是一致的。而相比之下,局部变量的生命周期则是动态的:每次从创建一个新变量的声明语句开始,直到该变量不再被引用为止,然后变量的存储空间可能被回收。函数的参数变量和返回值变量都是局部变量。它们在函数每次被调用的时候创建。
例如,下面是从1.4节的Lissajous程序摘录的代码片段:
for t := 0.0; t < cycles*2*math.Pi; t += res {
	x := math.Sin(t)
	y := math.Sin(t*freq + phase)
	img.SetColorIndex(size+int(x*size+0.5), size+int(y*size+0.5),
		blackIndex)
}
译注:函数的右小括弧也可以另起一行缩进,同时为了防止编译器在行尾自动插入分号而导致的编译错误,可以在末尾的参数变量后面显式插入逗号。像下面这样:
for t := 0.0; t < cycles*2*math.Pi; t += res {
	x := math.Sin(t)
	y := math.Sin(t*freq + phase)
	img.SetColorIndex(
		size+int(x*size+0.5), size+int(y*size+0.5),
		blackIndex, // 最后插入的逗号不会导致编译错误,这是Go编译器的一个特性
	)               // 小括弧另起一行缩进,和大括弧的风格保存一致
}
在每次循环的开始会创建临时变量t,然后在每次循环迭代中创建临时变量x和y。
那么Go语言的自动垃圾收集器是如何知道一个变量是何时可以被回收的呢?这里我们可以避开完整的技术细节,基本的实现思路是,从每个包级的变量和每个当前运行函数的每一个局部变量开始,通过指针或引用的访问路径遍历,是否可以找到该变量。如果不存在这样的访问路径,那么说明该变量是不可达的,也就是说它是否存在并不会影响程序后续的计算结果。
因为一个变量的有效周期只取决于是否可达,因此一个循环迭代内部的局部变量的生命周期可能超出其局部作用域。同时,局部变量可能在函数返回之后依然存在。
注意
编译器会自动选择在栈上还是在堆上分配局部变量的存储空间,但可能令人惊讶的是,这个选择并不是由用var还是new声明变量的方式决定的。
var global *int

func f() {
	var x int
	x = 1
	global = &x
}

func g() {
	y := new(int)
	*y = 1
}f函数里的x变量必须在堆上分配,因为它在函数退出后依然可以通过包一级的global变量找到,虽然它是在函数内部定义的;用Go语言的术语说,这个x局部变量从函数f中逃逸了。相反,当g函数返回时,变量*y将是不可达的,也就是说可以马上被回收的。因此,*y并没有从函数g中逃逸,编译器可以选择在栈上分配*y的存储空间(译注:也可以选择在堆上分配,然后由Go语言的GC回收这个变量的内存空间),虽然这里用的是new方式。其实在任何时候,你并不需为了编写正确的代码而要考虑变量的逃逸行为,要记住的是,逃逸的变量需要额外分配内存,同时对性能的优化可能会产生细微的影响。
Go语言的自动垃圾收集器对编写正确的代码是一个巨大的帮助,但也并不是说你完全不用考虑内存了。你虽然不需要显式地分配和释放内存,但是要编写高效的程序你依然需要了解变量的生命周期。例如,如果将指向短生命周期对象的指针保存到具有长生命周期的对象中,特别是保存到全局变量时,会阻止对短生命周期对象的垃圾回收(从而可能影响程序的性能)。
2.4. 赋值
使用赋值语句可以更新一个变量的值,最简单的赋值语句是将要被赋值的变量放在=的左边,新值的表达式放在=的右边。
x = 1                       // 命名变量的赋值
*p = true                   // 通过指针间接赋值
person.name = "bob"         // 结构体字段赋值
count[x] = count[x] * scale // 数组、slice或map的元素赋值
特定的二元算术运算符和赋值语句的复合操作有一个简洁形式,例如上面最后的语句可以重写为:
count[x] *= scale这样可以省去对变量表达式的重复计算。
数值变量也可以支持++递增和--递减语句(译注:自增和自减是语句,而不是表达式,因此x = i++之类的表达式是错误的):
v := 1
v++    // 等价方式 v = v + 1;v 变成 2
v--    // 等价方式 v = v - 1;v 变成 1
2.4.1. 元组赋值
元组赋值是另一种形式的赋值语句,它允许同时更新多个变量的值。在赋值之前,赋值语句右边的所有表达式将会先进行求值,然后再统一更新左边对应变量的值。这对于处理有些同时出现在元组赋值语句左右两边的变量很有帮助,例如我们可以这样交换两个变量的值:
x, y = y, x

a[i], a[j] = a[j], a[i]
或者是计算两个整数值的的最大公约数(GCD)(译注:Greatest Common Divisor的缩写,欧几里德的GCD是最早的非平凡算法):
func gcd(x, y int) int {
	for y != 0 {
		x, y = y, x%y
	}
	return x
}
或者是计算斐波纳契数列(Fibonacci)的第N个数:
func fib(n int) int {
	x, y := 0, 1
	for i := 0; i < n; i++ {
		x, y = y, x+y
	}
	return x
}
元组赋值也可以使一系列琐碎赋值更加紧凑(译注: 特别是在for循环的初始化部分):
i, j, k = 2, 3, 5但如果表达式太复杂的话,应该尽量避免过度使用元组赋值;因为每个变量单独赋值语句的写法可读性会更好。
有些表达式会产生多个值,比如调用一个有多个返回值的函数。当这样一个函数调用出现在元组赋值右边的表达式中时(译注:右边不能再有其它表达式),左边变量的数目必须和右边一致。
f, err = os.Open("foo.txt") // function call returns two values通常,这类函数会用额外的返回值来表达某种错误类型,例如os.Open是用额外的返回值返回一个error类型的错误,还有一些是用来返回布尔值,通常被称为ok。在稍后我们将看到的三个操作都是类似的用法。如果map查找(§4.3)、类型断言(§7.10)或通道接收(§8.4.2)出现在赋值语句的右边,它们都可能会产生两个结果,有一个额外的布尔结果表示操作是否成功:
v, ok = m[key]             // map lookup
v, ok = x.(T)              // type assertion
v, ok = <-ch               // channel receive
译注:map查找(§4.3)、类型断言(§7.10)或通道接收(§8.4.2)出现在赋值语句的右边时,并不一定是产生两个结果,也可能只产生一个结果。对于只产生一个结果的情形,map查找失败时会返回零值,类型断言失败时会发生运行时panic异常,通道接收失败时会返回零值(阻塞不算是失败)。例如下面的例子:
v = m[key]                // map查找,失败时返回零值
v = x.(T)                 // type断言,失败时panic异常
v = <-ch                  // 管道接收,失败时返回零值(阻塞不算是失败)

_, ok = m[key]            // map返回2个值
_, ok = mm[""], false     // map返回1个值
_ = mm[""] // map返回1个值和变量声明一样,我们可以用下划线空白标识符_来丢弃不需要的值。
_, err = io.Copy(dst, src) // 丢弃字节数
_, ok = x.(T)              // 只检测类型,忽略具体值
2.4.2. 可赋值性
赋值语句是显式的赋值形式,但是程序中还有很多地方会发生隐式的赋值行为:函数调用会隐式地将调用参数的值赋值给函数的参数变量,一个返回语句会隐式地将返回操作的值赋值给结果变量,一个复合类型的字面量(§4.2)也会产生赋值行为。例如下面的语句:
medals := []string{"gold", "silver", "bronze"}隐式地对slice的每个元素进行赋值操作,类似这样写的行为:
medals[0] = "gold"
medals[1] = "silver"
medals[2] = "bronze"
map和chan的元素,虽然不是普通的变量,但是也有类似的隐式赋值行为。
不管是隐式还是显式地赋值,在赋值语句左边的变量和右边最终的求到的值必须有相同的数据类型。更直白地说,只有右边的值对于左边的变量是可赋值的,赋值语句才是允许的。
可赋值性的规则对于不同类型有着不同要求,对每个新类型特殊的地方我们会专门解释。对于目前我们已经讨论过的类型,它的规则是简单的:类型必须完全匹配,nil可以赋值给任何指针或引用类型的变量。常量(§3.6)则有更灵活的赋值规则,因为这样可以避免不必要的显式的类型转换。
对于两个值是否可以用==或!=进行相等比较的能力也和可赋值能力有关系:对于任何类型的值的相等比较,第二个值必须是对第一个值类型对应的变量是可赋值的,反之亦然。和前面一样,我们会对每个新类型比较特殊的地方做专门的解释。
警告
没看懂:
对于两个值是否可以用==或!=进行相等比较的能力也和可赋值能力有关系:对于任何类型的值的相等比较,第二个值必须是对第一个值类型对应的变量是可赋值的,反之亦然。
2.5. 类型
变量或表达式的类型定义了对应存储值的属性特征,例如数值在内存的存储大小(或者是元素的bit个数),它们在内部是如何表达的,是否支持一些操作符,以及它们自己关联的方法集等。
在任何程序中都会存在一些变量有着相同的内部结构,但是却表示完全不同的概念。例如,一个int类型的变量可以用来表示一个循环的迭代索引、或者一个时间戳、或者一个文件描述符、或者一个月份;一个float64类型的变量可以用来表示每秒移动几米的速度、或者是不同温度单位下的温度;一个字符串可以用来表示一个密码或者一个颜色的名称。
一个类型声明语句创建了一个新的类型名称,和现有类型具有相同的底层结构。新命名的类型提供了一个方法,用来分隔不同概念的类型,这样即使它们底层类型相同也是不兼容的。
type 类型名字 底层类型类型声明语句一般出现在包一级,因此如果新创建的类型名字的首字符大写,则在包外部也可以使用。
译注:对于中文汉字,Unicode标志都作为小写字母处理,因此中文的命名默认不能导出;不过国内的用户针对该问题提出了不同的看法,根据RobPike的回复,在Go2中有可能会将中日韩等字符当作大写字母处理。下面是RobPik在 Issue763 的回复:
A solution that's been kicking around for a while:
For Go 2 (can't do it before then): Change the definition to “lower case letters and _ are package-local; all else is exported”. Then with non-cased languages, such as Japanese, we can write 日本语 for an exported name and _日本语 for a local name. This rule has no effect, relative to the Go 1 rule, with cased languages. They behave exactly the same.
为了说明类型声明,我们将不同温度单位分别定义为不同的类型:
// Package tempconv performs Celsius and Fahrenheit temperature computations.
package tempconv

import "fmt"

type Celsius float64    // 摄氏温度
type Fahrenheit float64 // 华氏温度

const (
	AbsoluteZeroC Celsius = -273.15 // 绝对零度
	FreezingC     Celsius = 0       // 结冰点温度
	BoilingC      Celsius = 100     // 沸水温度
)

func CToF(c Celsius) Fahrenheit { return Fahrenheit(c*9/5 + 32) }

func FToC(f Fahrenheit) Celsius { return Celsius((f - 32) * 5 / 9) }
我们在这个包声明了两种类型:Celsius和Fahrenheit分别对应不同的温度单位。它们虽然有着相同的底层类型float64,但是它们是不同的数据类型,因此它们不可以被相互比较或混在一个表达式运算。刻意区分类型,可以避免一些像无意中使用不同单位的温度混合计算导致的错误;因此需要一个类似Celsius(t)或Fahrenheit(t)形式的显式转型操作才能将float64转为对应的类型。Celsius(t)和Fahrenheit(t)是类型转换操作,它们并不是函数调用。类型转换不会改变值本身,但是会使它们的语义发生变化。另一方面,CToF和FToC两个函数则是对不同温度单位下的温度进行换算,它们会返回不同的值。
对于每一个类型T,都有一个对应的类型转换操作T(x),用于将x转为T类型(译注:如果T是指针类型,可能会需要用小括弧包装T,比如(*int)(0))。只有当两个类型的底层基础类型相同时,才允许这种转型操作,或者是两者都是指向相同底层结构的指针类型,这些转换只改变类型而不会影响值本身。如果x是可以赋值给T类型的值,那么x必然也可以被转为T类型,但是一般没有这个必要。
数值类型之间的转型也是允许的,并且在字符串和一些特定类型的slice之间也是可以转换的,在下一章我们会看到这样的例子。这类转换可能改变值的表现。例如,将一个浮点数转为整数将丢弃小数部分,将一个字符串转为[]byte类型的slice将拷贝一个字符串数据的副本。在任何情况下,运行时不会发生转换失败的错误(译注: 错误只会发生在编译阶段)。
底层数据类型决定了内部结构和表达方式,也决定是否可以像底层类型一样对内置运算符的支持。这意味着,Celsius和Fahrenheit类型的算术运算行为和底层的float64类型是一样的,正如我们所期望的那样。
fmt.Printf("%g\n", BoilingC-FreezingC) // "100" °C
boilingF := CToF(BoilingC)
fmt.Printf("%g\n", boilingF-CToF(FreezingC)) // "180" °F
fmt.Printf("%g\n", boilingF-FreezingC) // compile error: type mismatch比较运算符==和<也可以用来比较一个命名类型的变量和另一个有相同类型的变量,或有着相同底层类型的未命名类型的值之间做比较。但是如果两个值有着不同的类型,则不能直接进行比较:
var c Celsius
var f Fahrenheit
fmt.Println(c == 0)          // "true"
fmt.Println(f >= 0)          // "true"
fmt.Println(c == f)          // compile error: type mismatch
fmt.Println(c == Celsius(f)) // "true"!
注意最后那个语句。尽管看起来像函数调用,但是Celsius(f)是类型转换操作,它并不会改变值,仅仅是改变值的类型而已。测试为真的原因是因为c和f都是零值。
一个命名的类型可以提供书写方便,特别是可以避免一遍又一遍地书写复杂类型(译注:例如用匿名的结构体定义变量)。虽然对于像float64这种简单的底层类型没有简洁很多,但是如果是复杂的类型将会简洁很多,特别是我们即将讨论的结构体类型。
命名类型还可以为该类型的值定义新的行为。这些行为表示为一组关联到该类型的函数集合,我们称为类型的方法集。我们将在第六章中讨论方法的细节,这里只说些简单用法。
下面的声明语句,Celsius类型的参数c出现在了函数名的前面,表示声明的是Celsius类型的一个名叫String的方法,该方法返回该类型对象c带着°C温度单位的字符串:
func (c Celsius) String() string { return fmt.Sprintf("%g°C", c) }许多类型都会定义一个String方法,因为当使用fmt包的打印方法时,将会优先使用该类型对应的String方法返回的结果打印,我们将在7.1节讲述。
c := FToC(212.0)
fmt.Println(c.String()) // "100°C"
fmt.Printf("%v\n", c)   // "100°C"; no need to call String explicitly
fmt.Printf("%s\n", c)   // "100°C"
fmt.Println(c)          // "100°C"
fmt.Printf("%g\n", c)   // "100"; does not call String
fmt.Println(float64(c)) // "100"; does not call String
2.6. 包和文件
重要
如果包中含有多个.go源文件,它们将按照发给编译器的顺序进行初始化,Go语言的构建工具首先会将.go文件根据文件名排序,然后依次调用编译器编译。
对于在包级别声明的变量,如果有初始化表达式则用表达式初始化,还有一些没有初始化表达式的,例如某些表格数据初始化并不是一个简单的赋值过程。在这种情况下,我们可以用一个特殊的init初始化函数来简化初始化工作。每个文件都可以包含多个init初始化函数
Go语言中的包和其他语言的库或模块的概念类似,目的都是为了支持模块化、封装、单独编译和代码重用。一个包的源代码保存在一个或多个以.go为文件后缀名的源文件中,通常一个包所在目录路径的后缀是包的导入路径;例如包gopl.io/ch1/helloworld对应的目录路径是$GOPATH/src/gopl.io/ch1/helloworld。
每个包都对应一个独立的名字空间。例如,在image包中的Decode函数和在unicode/utf16包中的 Decode函数是不同的。要在外部引用该函数,必须显式使用image.Decode或utf16.Decode形式访问。
包还可以让我们通过控制哪些名字是外部可见的来隐藏内部实现信息。在Go语言中,一个简单的规则是:如果一个名字是大写字母开头的,那么该名字是导出的(译注:因为汉字不区分大小写,因此汉字开头的名字是没有导出的)。
为了演示包基本的用法,先假设我们的温度转换软件已经很流行,我们希望到Go语言社区也能使用这个包。我们该如何做呢?
我们把变量的声明、对应的常量,还有方法都放到tempconv.go源文件中:
// Package tempconv performs Celsius and Fahrenheit conversions.
package tempconv

import "fmt"

type Celsius float64
type Fahrenheit float64

const (
	AbsoluteZeroC Celsius = -273.15
	FreezingC     Celsius = 0
	BoilingC      Celsius = 100
)

func (c Celsius) String() string    { return fmt.Sprintf("%g°C", c) }
func (f Fahrenheit) String() string { return fmt.Sprintf("%g°F", f) }
转换函数则放在另一个conv.go源文件中:
package tempconv

// CToF converts a Celsius temperature to Fahrenheit.
func CToF(c Celsius) Fahrenheit { return Fahrenheit(c*9/5 + 32) }

// FToC converts a Fahrenheit temperature to Celsius.
func FToC(f Fahrenheit) Celsius { return Celsius((f - 32) * 5 / 9) }
每个源文件都是以包的声明语句开始,用来指明包的名字。当包被导入的时候,包内的成员将通过类似tempconv.CToF的形式访问。而包级别的名字,例如在一个文件声明的类型和常量,在同一个包的其他源文件也是可以直接访问的,就好像所有代码都在一个文件一样。要注意的是tempconv.go源文件导入了fmt包,但是conv.go源文件并没有,因为这个源文件中的代码并没有用到fmt包。
因为包级别的常量名都是以大写字母开头,它们可以像tempconv.AbsoluteZeroC这样被外部代码访问:
fmt.Printf("Brrrr! %v\n", tempconv.AbsoluteZeroC) // "Brrrr! -273.15°C"要将摄氏温度转换为华氏温度,需要先用import语句导入gopl.io/ch2/tempconv包,然后就可以使用下面的代码进行转换了:
fmt.Println(tempconv.CToF(tempconv.BoilingC)) // "212°F"在每个源文件的包声明前紧跟着的注释是包注释(§10.7.4)。通常,包注释的第一句应该先是包的功能概要说明。一个包通常只有一个源文件有包注释(译注:如果有多个包注释,目前的文档工具会根据源文件名的先后顺序将它们链接为一个包注释)。如果包注释很大,通常会放到一个独立的doc.go文件中。
练习 2.1: 向tempconv包添加类型、常量和函数用来处理Kelvin绝对温度的转换,Kelvin 绝对零度是−273.15°C,Kelvin绝对温度1K和摄氏度1°C的单位间隔是一样的。
2.6.1. 导入包
在Go语言程序中,每个包都有一个全局唯一的导入路径。导入语句中类似"gopl.io/ch2/tempconv"的字符串对应包的导入路径。Go语言的规范并没有定义这些字符串的具体含义或包来自哪里,它们是由构建工具来解释的。当使用Go语言自带的go工具箱时(第十章),一个导入路径代表一个目录中的一个或多个Go源文件。
除了包的导入路径,每个包还有一个包名,包名一般是短小的名字(并不要求包名是唯一的),包名在包的声明处指定。按照惯例,一个包的名字和包的导入路径的最后一个字段相同,例如gopl.io/ch2/tempconv包的名字一般是tempconv。
要使用gopl.io/ch2/tempconv包,需要先导入:
// Cf converts its numeric argument to Celsius and Fahrenheit.
package main

import (
	"fmt"
	"os"
	"strconv"

	"gopl.io/ch2/tempconv"
)

func main() {
	for _, arg := range os.Args[1:] {
		t, err := strconv.ParseFloat(arg, 64)
		if err != nil {
			fmt.Fprintf(os.Stderr, "cf: %v\n", err)
			os.Exit(1)
		}
		f := tempconv.Fahrenheit(t)
		c := tempconv.Celsius(t)
		fmt.Printf("%s = %s, %s = %s\n",
			f, tempconv.FToC(f), c, tempconv.CToF(c))
	}
}导入语句将导入的包绑定到一个短小的名字,然后通过该短小的名字就可以引用包中导出的全部内容。上面的导入声明将允许我们以tempconv.CToF的形式来访问gopl.io/ch2/tempconv包中的内容。在默认情况下,导入的包绑定到tempconv名字(译注:指包声明语句指定的名字),但是我们也可以绑定到另一个名称,以避免名字冲突(§10.4)。
cf程序将命令行输入的一个温度在Celsius和Fahrenheit温度单位之间转换:
$ go build gopl.io/ch2/cf
$ ./cf 32
32°F = 0°C, 32°C = 89.6°F
$ ./cf 212
212°F = 100°C, 212°C = 413.6°F
$ ./cf -40
-40°F = -40°C, -40°C = -40°F
如果导入了一个包,但是又没有使用该包将被当作一个编译错误处理。这种强制规则可以有效减少不必要的依赖,虽然在调试期间可能会让人讨厌,因为删除一个类似log.Print("got here!")的打印语句可能导致需要同时删除log包导入声明,否则,编译器将会发出一个错误。在这种情况下,我们需要将不必要的导入删除或注释掉。
练习 2.2: 写一个通用的单位转换程序,用类似cf程序的方式从命令行读取参数,如果缺省的话则是从标准输入读取参数,然后做类似Celsius和Fahrenheit的单位转换,长度单位可以对应英尺和米,重量单位可以对应磅和公斤等。
2.6.2. 包的初始化
包的初始化首先是解决包级变量的依赖顺序,然后按照包级变量声明出现的顺序依次初始化:
var a = b + c // a 第三个初始化, 为 3
var b = f()   // b 第二个初始化, 为 2, 通过调用 f (依赖c)
var c = 1     // c 第一个初始化, 为 1

func f() int { return c + 1 }
重要
如果包中含有多个.go源文件,它们将按照发给编译器的顺序进行初始化,Go语言的构建工具首先会将.go文件根据文件名排序,然后依次调用编译器编译。
对于在包级别声明的变量,如果有初始化表达式则用表达式初始化,还有一些没有初始化表达式的,例如某些表格数据初始化并不是一个简单的赋值过程。在这种情况下,我们可以用一个特殊的init初始化函数来简化初始化工作。每个文件都可以包含多个init初始化函数
func init() { /* ... */ }这样的init初始化函数除了不能被调用或引用外,其他行为和普通函数类似。在每个文件中的init初始化函数,在程序开始执行时按照它们声明的顺序被自动调用。
每个包在解决依赖的前提下,以导入声明的顺序初始化,每个包只会被初始化一次。因此,如果一个p包导入了q包,那么在p包初始化的时候可以认为q包必然已经初始化过了。初始化工作是自下而上进行的,main包最后被初始化。以这种方式,可以确保在main函数执行之前,所有依赖的包都已经完成初始化工作了。
下面的代码定义了一个PopCount函数,用于返回一个数字中含二进制1bit的个数。它使用init初始化函数来生成辅助表格pc,pc表格用于处理每个8bit宽度的数字含二进制的1bit的bit个数,这样的话在处理64bit宽度的数字时就没有必要循环64次,只需要8次查表就可以了。(这并不是最快的统计1bit数目的算法,但是它可以方便演示init函数的用法,并且演示了如何预生成辅助表格,这是编程中常用的技术)。
package popcount

// pc[i] is the population count of i.
var pc [256]byte

func init() {
	for i := range pc {
		pc[i] = pc[i/2] + byte(i&1)
	}
}

// PopCount returns the population count (number of set bits) of x.
func PopCount(x uint64) int {
	return int(pc[byte(x>>(0*8))] +
		pc[byte(x>>(1*8))] +
		pc[byte(x>>(2*8))] +
		pc[byte(x>>(3*8))] +
		pc[byte(x>>(4*8))] +
		pc[byte(x>>(5*8))] +
		pc[byte(x>>(6*8))] +
		pc[byte(x>>(7*8))])
}
译注:对于pc这类需要复杂处理的初始化,可以通过将初始化逻辑包装为一个匿名函数处理,像下面这样:
// pc[i] is the population count of i.
var pc [256]byte = func() (pc [256]byte) {
	for i := range pc {
		pc[i] = pc[i/2] + byte(i&1)
	}
	return
}()
要注意的是在init函数中,range循环只使用了索引,省略了没有用到的值部分。循环也可以这样写:
for i, _ := range pc {2.7. 作用域
一个声明语句将程序中的实体和一个名字关联,比如一个函数或一个变量。声明语句的作用域是指源代码中可以有效使用这个名字的范围。
不要将作用域和生命周期混为一谈。声明语句的作用域对应的是一个源代码的文本区域;它是一个编译时的属性。一个变量的生命周期是指程序运行时变量存在的有效时间段,在此时间区域内它可以被程序的其他部分引用;是一个运行时的概念。
句法块是由花括弧所包含的一系列语句,就像函数体或循环体花括弧包裹的内容一样。句法块内部声明的名字是无法被外部块访问的。这个块决定了内部声明的名字的作用域范围。我们可以把块(block)的概念推广到包括其他声明的群组,这些声明在代码中并未显式地使用花括号包裹起来,我们称之为词法块。对全局的源代码来说,存在一个整体的词法块,称为全局词法块;对于每个包;每个for、if和switch语句,也都有对应词法块;每个switch或select的分支也有独立的词法块;当然也包括显式书写的词法块(花括弧包含的语句)。
声明语句对应的词法域决定了作用域范围的大小。对于内置的类型、函数和常量,比如int、len和true等是在全局作用域的,因此可以在整个程序中直接使用。任何在函数外部(也就是包级语法域)声明的名字可以在同一个包的任何源文件中访问的。对于导入的包,例如tempconv导入的fmt包,则是对应源文件级的作用域,因此只能在当前的文件中访问导入的fmt包,当前包的其它源文件无法访问在当前源文件导入的包。还有许多声明语句,比如tempconv.CToF函数中的变量c,则是局部作用域的,它只能在函数内部(甚至只能是局部的某些部分)访问。
控制流标号,就是break、continue或goto语句后面跟着的那种标号,则是函数级的作用域。
一个程序可能包含多个同名的声明,只要它们在不同的词法域就没有关系。例如,你可以声明一个局部变量,和包级的变量同名。或者是像2.3.3节的例子那样,你可以将一个函数参数的名字声明为new,虽然内置的new是全局作用域的。但是物极必反,如果滥用不同词法域可重名的特性的话,可能导致程序很难阅读。
当编译器遇到一个名字引用时,它会对其定义进行查找,查找过程从最内层的词法域向全局的作用域进行。如果查找失败,则报告“未声明的名字”这样的错误。如果该名字在内部和外部的块分别声明过,则内部块的声明首先被找到。在这种情况下,内部声明屏蔽了外部同名的声明,让外部的声明的名字无法被访问:
func f() {}

var g = "g"

func main() {
	f := "f"
	fmt.Println(f) // "f"; local var f shadows package-level func f
	fmt.Println(g) // "g"; package-level var
	fmt.Println(h) // compile error: undefined: h
}
在函数中词法域可以深度嵌套,因此内部的一个声明可能屏蔽外部的声明。还有许多语法块是if或for等控制流语句构造的。下面的代码有三个不同的变量x,因为它们是定义在不同的词法域(这个例子只是为了演示作用域规则,但不是好的编程风格)。
func main() {
	x := "hello!"
	for i := 0; i < len(x); i++ {
		x := x[i]
		if x != '!' {
			x := x + 'A' - 'a'
			fmt.Printf("%c", x) // "HELLO" (one letter per iteration)
		}
	}
}在x[i]和x + 'A' - 'a'声明语句的初始化的表达式中都引用了外部作用域声明的x变量,稍后我们会解释这个。(注意,后面的表达式与unicode.ToUpper并不等价。)
正如上面例子所示,并不是所有的词法域都显式地对应到由花括弧包含的语句;还有一些隐含的规则。上面的for语句创建了两个词法域:花括弧包含的是显式的部分,是for的循环体部分词法域,另外一个隐式的部分则是循环的初始化部分,比如用于迭代变量i的初始化。隐式的词法域部分的作用域还包含条件测试部分和循环后的迭代部分(i++),当然也包含循环体词法域。
下面的例子同样有三个不同的x变量,每个声明在不同的词法域,一个在函数体词法域,一个在for隐式的初始化词法域,一个在for循环体词法域;只有两个块是显式创建的:
func main() {
	x := "hello"
	for _, x := range x {
		x := x + 'A' - 'a'
		fmt.Printf("%c", x) // "HELLO" (one letter per iteration)
	}
}
和for循环类似,if和switch语句也会在条件部分创建隐式词法域,还有它们对应的执行体词法域。下面的if-else测试链演示了x和y的有效作用域范围:
if x := f(); x == 0 {
	fmt.Println(x)
} else if y := g(x); x == y {
	fmt.Println(x, y)
} else {
	fmt.Println(x, y)
}
fmt.Println(x, y) // compile error: x and y are not visible here
第二个if语句嵌套在第一个内部,因此第一个if语句条件初始化词法域声明的变量在第二个if中也可以访问。switch语句的每个分支也有类似的词法域规则:条件部分为一个隐式词法域,然后是每个分支的词法域。
在包级别,声明的顺序并不会影响作用域范围,因此一个先声明的可以引用它自身或者是引用后面的一个声明,这可以让我们定义一些相互嵌套或递归的类型或函数。但是如果一个变量或常量递归引用了自身,则会产生编译错误。
在这个程序中:
if f, err := os.Open(fname); err != nil { // compile error: unused: f
	return err
}
f.ReadByte() // compile error: undefined f
f.Close()    // compile error: undefined f
变量f的作用域只在if语句内,因此后面的语句将无法引入它,这将导致编译错误。你可能会收到一个局部变量f没有声明的错误提示,具体错误信息依赖编译器的实现。
通常需要在if之前声明变量,这样可以确保后面的语句依然可以访问变量:
f, err := os.Open(fname)
if err != nil {
	return err
}
f.ReadByte()
f.Close()
你可能会考虑通过将ReadByte和Close移动到if的else块来解决这个问题:
if f, err := os.Open(fname); err != nil {
	return err
} else {
	// f and err are visible here too
	f.ReadByte()
	f.Close()
}
但这不是Go语言推荐的做法,Go语言的习惯是在if中处理错误然后直接返回,这样可以确保正常执行的语句不需要代码缩进。
要特别注意短变量声明语句的作用域范围,考虑下面的程序,它的目的是获取当前的工作目录然后保存到一个包级的变量中。这本来可以通过直接调用os.Getwd完成,但是将这个从主逻辑中分离出来可能会更好,特别是在需要处理错误的时候。函数log.Fatalf用于打印日志信息,然后调用os.Exit(1)终止程序。
var cwd string

func init() {
	cwd, err := os.Getwd() // compile error: unused: cwd
	if err != nil {
		log.Fatalf("os.Getwd failed: %v", err)
	}
}虽然cwd在外部已经声明过,但是:=语句还是将cwd和err重新声明为新的局部变量。因为内部声明的cwd将屏蔽外部的声明,因此上面的代码并不会正确更新包级声明的cwd变量。
由于当前的编译器会检测到局部声明的cwd并没有使用,然后报告这可能是一个错误,但是这种检测并不可靠。因为一些小的代码变更,例如增加一个局部cwd的打印语句,就可能导致这种检测失效。
var cwd string

func init() {
	cwd, err := os.Getwd() // NOTE: wrong!
	if err != nil {
		log.Fatalf("os.Getwd failed: %v", err)
	}
	log.Printf("Working directory = %s", cwd)
}
全局的cwd变量依然是没有被正确初始化的,而且看似正常的日志输出更是让这个BUG更加隐晦。
有许多方式可以避免出现类似潜在的问题。最直接的方法是通过单独声明err变量,来避免使用:=的简短声明方式:
var cwd string

func init() {
	var err error
	cwd, err = os.Getwd()
	if err != nil {
		log.Fatalf("os.Getwd failed: %v", err)
	}
}
3.1. 整型
Go语言的数值类型包括几种不同大小的整数、浮点数和复数。每种数值类型都决定了对应的大小范围和是否支持正负符号。让我们先从整数类型开始介绍。
Go语言同时提供了有符号和无符号类型的整数运算。这里有int8、int16、int32和int64四种截然不同大小的有符号整数类型,分别对应8、16、32、64bit大小的有符号整数,与此对应的是uint8、uint16、uint32和uint64四种无符号整数类型。
这里还有两种一般对应特定CPU平台机器字大小的有符号和无符号整数int和uint;其中int是应用最广泛的数值类型。这两种类型都有同样的大小,32或64bit,但是我们不能对此做任何的假设;因为不同的编译器即使在相同的硬件平台上可能产生不同的大小。
Unicode字符rune类型是和int32等价的类型,通常用于表示一个Unicode码点。这两个名称可以互换使用。同样byte也是uint8类型的等价类型,byte类型一般用于强调数值是一个原始的数据而不是一个小的整数。
最后,还有一种无符号的整数类型uintptr,没有指定具体的bit大小但是足以容纳指针。uintptr类型只有在底层编程时才需要,特别是Go语言和C语言函数库或操作系统接口相交互的地方。我们将在第十三章的unsafe包相关部分看到类似的例子。
不管它们的具体大小,int、uint和uintptr是不同类型的兄弟类型。其中int和int32也是不同的类型,即使int的大小也是32bit,在需要将int当作int32类型的地方需要一个显式的类型转换操作,反之亦然。
其中有符号整数采用2的补码形式表示,也就是最高bit位用来表示符号位,一个n-bit的有符号数的值域是从-2n-1到2n-1-1。无符号整数的所有bit位都用于表示非负数,值域是0到2n-1。例如,int8类型整数的值域是从-128到127,而uint8类型整数的值域是从0到255。
下面是Go语言中关于算术运算、逻辑运算和比较运算的二元运算符,它们按照优先级递减的顺序排列:
*      /      %      <<       >>     &       &^
+      -      |      ^
==     !=     <      <=       >      >=
&&
||二元运算符有五种优先级。在同一个优先级,使用左优先结合规则,但是使用括号可以明确优先顺序,使用括号也可以用于提升优先级,例如mask & (1 << 28)。
对于上表中前两行的运算符,例如+运算符还有一个与赋值相结合的对应运算符+=,可以用于简化赋值语句。
算术运算符+、-、*和/可以适用于整数、浮点数和复数,但是取模运算符%仅用于整数间的运算。对于不同编程语言,%取模运算的行为可能并不相同。在Go语言中,%取模运算符的符号和被取模数的符号总是一致的,因此-5%3和-5%-3结果都是-2。除法运算符/的行为则依赖于操作数是否全为整数,比如5.0/4.0的结果是1.25,但是5/4的结果是1,因为整数除法会向着0方向截断余数。
一个算术运算的结果,不管是有符号或者是无符号的,如果需要更多的bit位才能正确表示的话,就说明计算结果是溢出了。超出的高位的bit位部分将被丢弃。如果原始的数值是有符号类型,而且最左边的bit位是1的话,那么最终结果可能是负的,例如int8的例子:
var u uint8 = 255
fmt.Println(u, u+1, u*u) // "255 0 1"

var i int8 = 127
fmt.Println(i, i+1, i*i) // "127 -128 1"
两个相同的整数类型可以使用下面的二元比较运算符进行比较;比较表达式的结果是布尔类型。
==    等于
!=    不等于
<     小于
<=    小于等于
>     大于
>=    大于等于
事实上,布尔型、数字类型和字符串等基本类型都是可比较的,也就是说两个相同类型的值可以用==和!=进行比较。此外,整数、浮点数和字符串可以根据比较结果排序。许多其它类型的值可能是不可比较的,因此也就可能是不可排序的。对于我们遇到的每种类型,我们需要保证规则的一致性。
这里是一元的加法和减法运算符:
+      一元加法(无效果)
-      负数
对于整数,+x是0+x的简写,-x则是0-x的简写;对于浮点数和复数,+x就是x,-x则是x 的负数。
Go语言还提供了以下的bit位操作运算符,前面4个操作运算符并不区分是有符号还是无符号数:
&      位运算 AND
|      位运算 OR
^      位运算 XOR
&^     位清空(AND NOT)
<<     左移
>> 右移位操作运算符^作为二元运算符时是按位异或(XOR),当用作一元运算符时表示按位取反;也就是说,它返回一个每个bit位都取反的数。位操作运算符&^用于按位置零(AND NOT):如果对应y中bit位为1的话,表达式z = x &^ y结果z的对应的bit位为0,否则z对应的bit位等于x相应的bit位的值。
下面的代码演示了如何使用位操作解释uint8类型值的8个独立的bit位。它使用了Printf函数的%b参数打印二进制格式的数字;其中%08b中08表示打印至少8个字符宽度,不足的前缀部分用0填充。
var x uint8 = 1<<1 | 1<<5
var y uint8 = 1<<1 | 1<<2

fmt.Printf("%08b\n", x) // "00100010", the set {1, 5}
fmt.Printf("%08b\n", y) // "00000110", the set {1, 2}

fmt.Printf("%08b\n", x&y)  // "00000010", the intersection {1}
fmt.Printf("%08b\n", x|y)  // "00100110", the union {1, 2, 5}
fmt.Printf("%08b\n", x^y)  // "00100100", the symmetric difference {2, 5}
fmt.Printf("%08b\n", x&^y) // "00100000", the difference {5}

for i := uint(0); i < 8; i++ {
	if x&(1<<i) != 0 { // membership test
		fmt.Println(i) // "1", "5"
	}
}

fmt.Printf("%08b\n", x<<1) // "01000100", the set {2, 6}
fmt.Printf("%08b\n", x>>1) // "00010001", the set {0, 4}
(6.5节给出了一个可以远大于一个字节的整数集的实现。)
在x<<n和x>>n移位运算中,决定了移位操作的bit数部分必须是无符号数;被操作的x可以是有符号数或无符号数。算术上,一个x<<n左移运算等价于乘以$2n$,一个`x>>n`右移运算等价于除以$2n$。
左移运算用零填充右边空缺的bit位,无符号数的右移运算也是用0填充左边空缺的bit位,但是有符号数的右移运算会用符号位的值填充左边空缺的bit位。因为这个原因,最好用无符号运算,这样你可以将整数完全当作一个bit位模式处理。
尽管Go语言提供了无符号数的运算,但即使数值本身不可能出现负数,我们还是倾向于使用有符号的int类型,就像数组的长度那样,虽然使用uint无符号类型似乎是一个更合理的选择。事实上,内置的len函数返回一个有符号的int,我们可以像下面例子那样处理逆序循环。
medals := []string{"gold", "silver", "bronze"}
for i := len(medals) - 1; i >= 0; i-- {
	fmt.Println(medals[i]) // "bronze", "silver", "gold"
}另一个选择对于上面的例子来说将是灾难性的。如果len函数返回一个无符号数,那么i也将是无符号的uint类型,然后条件i >= 0则永远为真。在三次迭代之后,也就是i == 0时,i--语句将不会产生-1,而是变成一个uint类型的最大值(可能是$2^64-1$),然后medals[i]表达式运行时将发生panic异常(§5.9),也就是试图访问一个slice范围以外的元素。
出于这个原因,无符号数往往只有在位运算或其它特殊的运算场景才会使用,就像bit集合、分析二进制文件格式或者是哈希和加密操作等。它们通常并不用于仅仅是表达非负数量的场合。
一般来说,需要一个显式的转换将一个值从一种类型转化为另一种类型,并且算术和逻辑运算的二元操作中必须是相同的类型。虽然这偶尔会导致需要很长的表达式,但是它消除了所有和类型相关的问题,而且也使得程序容易理解。
在很多场景,会遇到类似下面代码的常见的错误:
var apples int32 = 1
var oranges int16 = 2
var compote int = apples + oranges // compile error
当尝试编译这三个语句时,将产生一个错误信息:
invalid operation: apples + oranges (mismatched types int32 and int16)这种类型不匹配的问题可以有几种不同的方法修复,最常见方法是将它们都显式转型为一个常见类型:
var compote = int(apples) + int(oranges)如2.5节所述,对于每种类型T,如果转换允许的话,类型转换操作T(x)将x转换为T类型。许多整数之间的相互转换并不会改变数值;它们只是告诉编译器如何解释这个值。但是对于将一个大尺寸的整数类型转为一个小尺寸的整数类型,或者是将一个浮点数转为整数,可能会改变数值或丢失精度:
f := 3.141 // a float64
i := int(f)
fmt.Println(f, i) // "3.141 3"
f = 1.99
fmt.Println(int(f)) // "1"
浮点数到整数的转换将丢失任何小数部分,然后向数轴零方向截断。你应该避免对可能会超出目标类型表示范围的数值做类型转换,因为截断的行为可能依赖于具体的实现:
f := 1e100  // a float64
i := int(f) // 结果依赖于具体实现
任何大小的整数字面值都可以用以0开始的八进制格式书写,例如0666;或用以0x或0X开头的十六进制格式书写,例如0xdeadbeef。十六进制数字可以用大写或小写字母。如今八进制数据通常用于POSIX操作系统上的文件访问权限标志,十六进制数字则更强调数字值的bit位模式。
当使用fmt包打印一个数值时,我们可以用%d、%o或%x参数控制输出的进制格式,就像下面的例子:
o := 0666
fmt.Printf("%d %[1]o %#[1]o\n", o) // "438 666 0666"
x := int64(0xdeadbeef)
fmt.Printf("%d %[1]x %#[1]x %#[1]X\n", x)
// Output:
// 3735928559 deadbeef 0xdeadbeef 0XDEADBEEF请注意fmt的两个使用技巧。通常Printf格式化字符串包含多个%参数时将会包含对应相同数量的额外操作数,但是%之后的[1]副词告诉Printf函数再次使用第一个操作数。第二,%后的#副词告诉Printf在用%o、%x或%X输出时生成0、0x或0X前缀。
字符面值通过一对单引号直接包含对应字符。最简单的例子是ASCII中类似'a'写法的字符面值,但是我们也可以通过转义的数值来表示任意的Unicode码点对应的字符,马上将会看到这样的例子。
字符使用%c参数打印,或者是用%q参数打印带单引号的字符:
ascii := 'a'
unicode := '国'
newline := '\n'
fmt.Printf("%d %[1]c %[1]q\n", ascii)   // "97 a 'a'"
fmt.Printf("%d %[1]c %[1]q\n", unicode) // "22269 国 '国'"
fmt.Printf("%d %[1]q\n", newline)       // "10 '\n'"
3.2. 浮点数
Go语言提供了两种精度的浮点数,float32和float64。它们的算术规范由IEEE754浮点数国际标准定义,该浮点数规范被所有现代的CPU支持。
这些浮点数类型的取值范围可以从很微小到很巨大。浮点数的范围极限值可以在math包找到。常量math.MaxFloat32表示float32能表示的最大数值,大约是 3.4e38;对应的math.MaxFloat64常量大约是1.8e308。它们分别能表示的最小值近似为1.4e-45和4.9e-324。
一个float32类型的浮点数可以提供大约6个十进制数的精度,而float64则可以提供约15个十进制数的精度;通常应该优先使用float64类型,因为float32类型的累计计算误差很容易扩散,并且float32能精确表示的正整数并不是很大(译注:因为float32的有效bit位只有23个,其它的bit位用于指数和符号;当整数大于23bit能表达的范围时,float32的表示将出现误差):
var f float32 = 16777216 // 1 << 24
fmt.Println(f == f+1)    // "true"!
浮点数的字面值可以直接写小数部分,像这样:
const e = 2.71828 // (approximately)小数点前面或后面的数字都可能被省略(例如.707或1.)。很小或很大的数最好用科学计数法书写,通过e或E来指定指数部分:
const Avogadro = 6.02214129e23  // 阿伏伽德罗常数
const Planck   = 6.62606957e-34 // 普朗克常数
用Printf函数的%g参数打印浮点数,将采用更紧凑的表示形式打印,并提供足够的精度,但是对应表格的数据,使用%e(带指数)或%f的形式打印可能更合适。所有的这三个打印形式都可以指定打印的宽度和控制打印精度。
for x := 0; x < 8; x++ {
	fmt.Printf("x = %d e^x = %8.3f\n", x, math.Exp(float64(x)))
}
上面代码打印e的幂,打印精度是小数点后三个小数精度和8个字符宽度:
x = 0       e^x =    1.000
x = 1       e^x =    2.718
x = 2       e^x =    7.389
x = 3       e^x =   20.086
x = 4       e^x =   54.598
x = 5       e^x =  148.413
x = 6       e^x =  403.429
x = 7       e^x = 1096.633
math包中除了提供大量常用的数学函数外,还提供了IEEE754浮点数标准中定义的特殊值的创建和测试:正无穷大和负无穷大,分别用于表示太大溢出的数字和除零的结果;还有NaN非数,一般用于表示无效的除法操作结果0/0或Sqrt(-1).
var z float64
fmt.Println(z, -z, 1/z, -1/z, z/z) // "0 -0 +Inf -Inf NaN"
函数math.IsNaN用于测试一个数是否是非数NaN,math.NaN则返回非数对应的值。虽然可以用math.NaN来表示一个非法的结果,但是测试一个结果是否是非数NaN则是充满风险的,因为NaN和任何数都是不相等的(译注:在浮点数中,NaN、正无穷大和负无穷大都不是唯一的,每个都有非常多种的bit模式表示):
nan := math.NaN()
fmt.Println(nan == nan, nan < nan, nan > nan) // "false false false"
如果一个函数返回的浮点数结果可能失败,最好的做法是用单独的标志报告失败,像这样:
func compute() (value float64, ok bool) {
	// ...
	if failed {
		return 0, false
	}
	return result, true
}
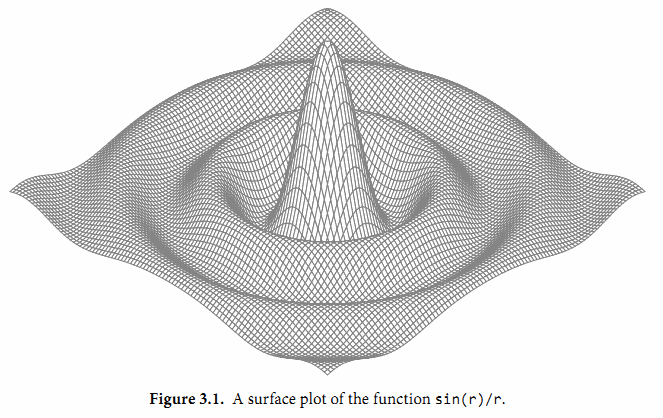
接下来的程序演示了通过浮点计算生成的图形。它是带有两个参数的z = f(x, y)函数的三维形式,使用了可缩放矢量图形(SVG)格式输出,SVG是一个用于矢量线绘制的XML标准。图3.1显示了sin(r)/r函数的输出图形,其中r是sqrt(x*x+y*y)。
// Surface computes an SVG rendering of a 3-D surface function.
package main

import (
	"fmt"
	"math"
)

const (
	width, height = 600, 320            // canvas size in pixels
	cells         = 100                 // number of grid cells
	xyrange       = 30.0                // axis ranges (-xyrange..+xyrange)
	xyscale       = width / 2 / xyrange // pixels per x or y unit
	zscale        = height * 0.4        // pixels per z unit
	angle         = math.Pi / 6         // angle of x, y axes (=30°)
)

var sin30, cos30 = math.Sin(angle), math.Cos(angle) // sin(30°), cos(30°)

func main() {
	fmt.Printf("<svg xmlns='http://www.w3.org/2000/svg' "+
		"style='stroke: grey; fill: white; stroke-width: 0.7' "+
		"width='%d' height='%d'>", width, height)
	for i := 0; i < cells; i++ {
		for j := 0; j < cells; j++ {
			ax, ay := corner(i+1, j)
			bx, by := corner(i, j)
			cx, cy := corner(i, j+1)
			dx, dy := corner(i+1, j+1)
			fmt.Printf("<polygon points='%g,%g %g,%g %g,%g %g,%g'/>\n",
				ax, ay, bx, by, cx, cy, dx, dy)
		}
	}
	fmt.Println("</svg>")
}

func corner(i, j int) (float64, float64) {
	// Find point (x,y) at corner of cell (i,j).
	x := xyrange * (float64(i)/cells - 0.5)
	y := xyrange * (float64(j)/cells - 0.5)

	// Compute surface height z.
	z := f(x, y)

	// Project (x,y,z) isometrically onto 2-D SVG canvas (sx,sy).
	sx := width/2 + (x-y)*cos30*xyscale
	sy := height/2 + (x+y)*sin30*xyscale - z*zscale
	return sx, sy
}

func f(x, y float64) float64 {
	r := math.Hypot(x, y) // distance from (0,0)
	return math.Sin(r) / r
}
要注意的是corner函数返回了两个结果,分别对应每个网格顶点的坐标参数。
要解释这个程序是如何工作的需要一些基本的几何学知识,但是我们可以跳过几何学原理,因为程序的重点是演示浮点数运算。程序的本质是三个不同的坐标系中映射关系,如图3.2所示。第一个是100x100的二维网格,对应整数坐标(i,j),从远处的(0,0)位置开始。我们从远处向前面绘制,因此远处先绘制的多边形有可能被前面后绘制的多边形覆盖。
第二个坐标系是一个三维的网格浮点坐标(x,y,z),其中x和y是i和j的线性函数,通过平移转换为网格单元的中心,然后用xyrange系数缩放。高度z是函数f(x,y)的值。
第三个坐标系是一个二维的画布,起点(0,0)在左上角。画布中点的坐标用(sx,sy)表示。我们使用等角投影将三维点(x,y,z)投影到二维的画布中。
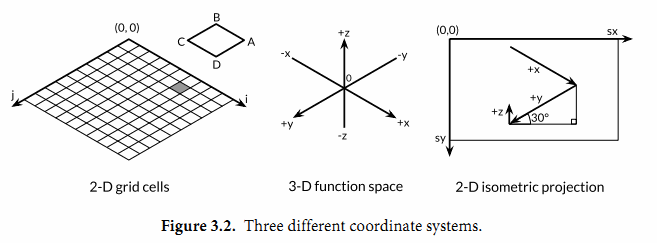
画布中从远处到右边的点对应较大的x值和较大的y值。并且画布中x和y值越大,则对应的z值越小。x和y的垂直和水平缩放系数来自30度角的正弦和余弦值。z的缩放系数0.4,是一个任意选择的参数。
对于二维网格中的每一个网格单元,main函数计算单元的四个顶点在画布中对应多边形ABCD的顶点,其中B对应(i,j)顶点位置,A、C和D是其它相邻的顶点,然后输出SVG的绘制指令。
3.3. 复数
Go语言提供了两种精度的复数类型:complex64和complex128,分别对应float32和float64两种浮点数精度。内置的complex函数用于构建复数,内建的real和imag函数分别返回复数的实部和虚部:
var x complex128 = complex(1, 2) // 1+2i
var y complex128 = complex(3, 4) // 3+4i
fmt.Println(x*y)                 // "(-5+10i)"
fmt.Println(real(x*y))           // "-5"
fmt.Println(imag(x*y))           // "10"
如果一个浮点数面值或一个十进制整数面值后面跟着一个i,例如3.141592i或2i,它将构成一个复数的虚部,复数的实部是0:
fmt.Println(1i * 1i) // "(-1+0i)", i^2 = -1在常量算术规则下,一个复数常量可以加到另一个普通数值常量(整数或浮点数、实部或虚部),我们可以用自然的方式书写复数,就像1+2i或与之等价的写法2i+1。上面x和y的声明语句还可以简化:
x := 1 + 2i
y := 3 + 4i
复数也可以用==和!=进行相等比较。只有两个复数的实部和虚部都相等的时候它们才是相等的(译注:浮点数的相等比较是危险的,需要特别小心处理精度问题)。
math/cmplx包提供了复数处理的许多函数,例如求复数的平方根函数和求幂函数。
fmt.Println(cmplx.Sqrt(-1)) // "(0+1i)"下面的程序使用complex128复数算法来生成一个Mandelbrot图像。
// Mandelbrot emits a PNG image of the Mandelbrot fractal.
package main

import (
	"image"
	"image/color"
	"image/png"
	"math/cmplx"
	"os"
)


func main() {
	const (
		xmin, ymin, xmax, ymax = -2, -2, +2, +2
		width, height          = 1024, 1024
	)

	img := image.NewRGBA(image.Rect(0, 0, width, height))
	for py := 0; py < height; py++ {
		y := float64(py)/height*(ymax-ymin) + ymin
		for px := 0; px < width; px++ {
			x := float64(px)/width*(xmax-xmin) + xmin
			z := complex(x, y)
			// Image point (px, py) represents complex value z.
			img.Set(px, py, mandelbrot(z))
		}
	}
	png.Encode(os.Stdout, img) // NOTE: ignoring errors
}

func mandelbrot(z complex128) color.Color {
	const iterations = 200
	const contrast = 15

	var v complex128
	for n := uint8(0); n < iterations; n++ {
		v = v*v + z
		if cmplx.Abs(v) > 2 {
			return color.Gray{255 - contrast*n}
		}
	}
	return color.Black
}
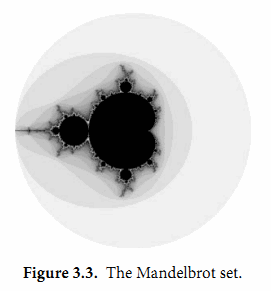
用于遍历1024x1024图像每个点的两个嵌套的循环对应-2到+2区间的复数平面。程序反复测试每个点对应复数值平方值加一个增量值对应的点是否超出半径为2的圆。如果超过了,通过根据预设置的逃逸迭代次数对应的灰度颜色来代替。如果不是,那么该点属于Mandelbrot集合,使用黑色颜色标记。最终程序将生成的PNG格式分形图像输出到标准输出,如图3.3所示。
3.4. 布尔型
一个布尔类型的值只有两种:true和false。if和for语句的条件部分都是布尔类型的值,并且==和<等比较操作也会产生布尔型的值。一元操作符!对应逻辑非操作,因此!true的值为false,更罗嗦的说法是(!true==false)==true,虽然表达方式不一样,不过我们一般会采用简洁的布尔表达式,就像用x来表示x==true。
布尔值可以和&&(AND)和||(OR)操作符结合,并且有短路行为:如果运算符左边值已经可以确定整个布尔表达式的值,那么运算符右边的值将不再被求值,因此下面的表达式总是安全的:
s != "" && s[0] == 'x'其中s[0]操作如果应用于空字符串将会导致panic异常。
因为&&的优先级比||高(助记:&&对应逻辑乘法,||对应逻辑加法,乘法比加法优先级要高),下面形式的布尔表达式是不需要加小括弧的:
if 'a' <= c && c <= 'z' ||
	'A' <= c && c <= 'Z' ||
	'0' <= c && c <= '9' {
	// ...ASCII letter or digit...
}
布尔值并不会隐式转换为数字值0或1,反之亦然。必须使用一个显式的if语句辅助转换:
i := 0
if b {
	i = 1
}
如果需要经常做类似的转换,包装成一个函数会更方便:
// btoi returns 1 if b is true and 0 if false.
func btoi(b bool) int {
	if b {
		return 1
	}
	return 0
}
数字到布尔型的逆转换则非常简单,不过为了保持对称,我们也可以包装一个函数:
// itob reports whether i is non-zero.
func itob(i int) bool { return i != 0 }
3.5. 字符串
一个字符串是一个不可改变的字节序列。字符串可以包含任意的数据,包括byte值0,但是通常是用来包含人类可读的文本。文本字符串通常被解释为采用UTF8编码的Unicode码点(rune)序列,我们稍后会详细讨论这个问题。
内置的len函数可以返回一个字符串中的字节数目(不是rune字符数目),索引操作s[i]返回第i个字节的字节值,i必须满足0 ≤ i< len(s)条件约束。
s := "hello, world"
fmt.Println(len(s))     // "12"
fmt.Println(s[0], s[7]) // "104 119" ('h' and 'w')
如果试图访问超出字符串索引范围的字节将会导致panic异常:
c := s[len(s)] // panic: index out of range第i个字节并不一定是字符串的第i个字符,因为对于非ASCII字符的UTF8编码会要两个或多个字节。我们先简单说下字符的工作方式。
子字符串操作s[i:j]基于原始的s字符串的第i个字节开始到第j个字节(并不包含j本身)生成一个新字符串。生成的新字符串将包含j-i个字节。
fmt.Println(s[0:5]) // "hello"同样,如果索引超出字符串范围或者j小于i的话将导致panic异常。
不管i还是j都可能被忽略,当它们被忽略时将采用0作为开始位置,采用len(s)作为结束的位置。
fmt.Println(s[:5]) // "hello"
fmt.Println(s[7:]) // "world"
fmt.Println(s[:])  // "hello, world"
其中+操作符将两个字符串连接构造一个新字符串:
fmt.Println("goodbye" + s[5:]) // "goodbye, world"字符串可以用==和<进行比较;比较通过逐个字节比较完成的,因此比较的结果是字符串自然编码的顺序。
字符串的值是不可变的:一个字符串包含的字节序列永远不会被改变,当然我们也可以给一个字符串变量分配一个新字符串值。可以像下面这样将一个字符串追加到另一个字符串:
s := "left foot"
t := s
s += ", right foot"
这并不会导致原始的字符串值被改变,但是变量s将因为+=语句持有一个新的字符串值,但是t依然是包含原先的字符串值。
fmt.Println(s) // "left foot, right foot"
fmt.Println(t) // "left foot"
因为字符串是不可修改的,因此尝试修改字符串内部数据的操作也是被禁止的:
s[0] = 'L' // compile error: cannot assign to s[0]不变性意味着如果两个字符串共享相同的底层数据的话也是安全的,这使得复制任何长度的字符串代价是低廉的。同样,一个字符串s和对应的子字符串切片s[7:]的操作也可以安全地共享相同的内存,因此字符串切片操作代价也是低廉的。在这两种情况下都没有必要分配新的内存。 图3.4演示了一个字符串和两个子串共享相同的底层数据。
3.5.1. 字符串面值
字符串值也可以用字符串面值方式编写,只要将一系列字节序列包含在双引号内即可:
"Hello, world"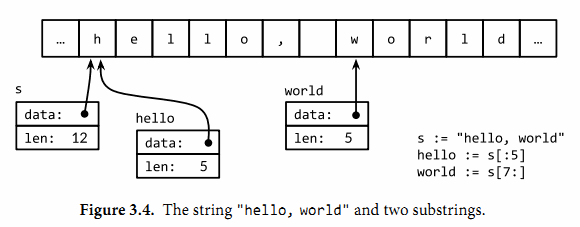
因为Go语言源文件总是用UTF8编码,并且Go语言的文本字符串也以UTF8编码的方式处理,因此我们可以将Unicode码点也写到字符串面值中。
在一个双引号包含的字符串面值中,可以用以反斜杠\开头的转义序列插入任意的数据。下面的换行、回车和制表符等是常见的ASCII控制代码的转义方式:
\a      响铃
\b      退格
\f      换页
\n      换行
\r      回车
\t      制表符
\v      垂直制表符
\'      单引号(只用在 '\'' 形式的rune符号面值中)
\"      双引号(只用在 "..." 形式的字符串面值中)
\\ 反斜杠可以通过十六进制或八进制转义在字符串面值中包含任意的字节。一个十六进制的转义形式是\xhh,其中两个h表示十六进制数字(大写或小写都可以)。一个八进制转义形式是\ooo,包含三个八进制的o数字(0到7),但是不能超过\377(译注:对应一个字节的范围,十进制为255)。每一个单一的字节表达一个特定的值。稍后我们将看到如何将一个Unicode码点写到字符串面值中。
一个原生的字符串面值形式是`...`,使用反引号代替双引号。在原生的字符串面值中,没有转义操作;全部的内容都是字面的意思,包含退格和换行,因此一个程序中的原生字符串面值可能跨越多行(译注:在原生字符串面值内部是无法直接写`字符的,可以用八进制或十六进制转义或+"`"连接字符串常量完成)。唯一的特殊处理是会删除回车以保证在所有平台上的值都是一样的,包括那些把回车也放入文本文件的系统(译注:Windows系统会把回车和换行一起放入文本文件中)。
原生字符串面值用于编写正则表达式会很方便,因为正则表达式往往会包含很多反斜杠。原生字符串面值同时被广泛应用于HTML模板、JSON面值、命令行提示信息以及那些需要扩展到多行的场景。
const GoUsage = `Go is a tool for managing Go source code.

Usage:
	go command [arguments]
...`
3.5.2. Unicode
在很久以前,世界还是比较简单的,起码计算机世界就只有一个ASCII字符集:美国信息交换标准代码。ASCII,更准确地说是美国的ASCII,使用7bit来表示128个字符:包含英文字母的大小写、数字、各种标点符号和设备控制符。对于早期的计算机程序来说,这些就足够了,但是这也导致了世界上很多其他地区的用户无法直接使用自己的符号系统。随着互联网的发展,混合多种语言的数据变得很常见(译注:比如本身的英文原文或中文翻译都包含了ASCII、中文、日文等多种语言字符)。如何有效处理这些包含了各种语言的丰富多样的文本数据呢?
答案就是使用Unicode( http://unicode.org ),它收集了这个世界上所有的符号系统,包括重音符号和其它变音符号,制表符和回车符,还有很多神秘的符号,每个符号都分配一个唯一的Unicode码点,Unicode码点对应Go语言中的rune整数类型(译注:rune是int32等价类型)。
在第八版本的Unicode标准里收集了超过120,000个字符,涵盖超过100多种语言。这些在计算机程序和数据中是如何体现的呢?通用的表示一个Unicode码点的数据类型是int32,也就是Go语言中rune对应的类型;它的同义词rune符文正是这个意思。
我们可以将一个符文序列表示为一个int32序列。这种编码方式叫UTF-32或UCS-4,每个Unicode码点都使用同样大小的32bit来表示。这种方式比较简单统一,但是它会浪费很多存储空间,因为大多数计算机可读的文本是ASCII字符,本来每个ASCII字符只需要8bit或1字节就能表示。而且即使是常用的字符也远少于65,536个,也就是说用16bit编码方式就能表达常用字符。但是,还有其它更好的编码方法吗?
3.5.3. UTF-8
UTF8是一个将Unicode码点编码为字节序列的变长编码。UTF8编码是由Go语言之父Ken Thompson和Rob Pike共同发明的,现在已经是Unicode的标准。UTF8编码使用1到4个字节来表示每个Unicode码点,ASCII部分字符只使用1个字节,常用字符部分使用2或3个字节表示。每个符号编码后第一个字节的高端bit位用于表示编码总共有多少个字节。如果第一个字节的高端bit为0,则表示对应7bit的ASCII字符,ASCII字符每个字符依然是一个字节,和传统的ASCII编码兼容。如果第一个字节的高端bit是110,则说明需要2个字节;后续的每个高端bit都以10开头。更大的Unicode码点也是采用类似的策略处理。
0xxxxxxx                             runes 0-127    (ASCII)
110xxxxx 10xxxxxx                    128-2047       (values <128 unused)
1110xxxx 10xxxxxx 10xxxxxx           2048-65535     (values <2048 unused)
11110xxx 10xxxxxx 10xxxxxx 10xxxxxx  65536-0x10ffff (other values unused)
变长的编码无法直接通过索引来访问第n个字符,但是UTF8编码获得了很多额外的优点。首先UTF8编码比较紧凑,完全兼容ASCII码,并且可以自动同步:它可以通过向前回朔最多3个字节就能确定当前字符编码的开始字节的位置。它也是一个前缀编码,所以当从左向右解码时不会有任何歧义也并不需要向前查看(译注:像GBK之类的编码,如果不知道起点位置则可能会出现歧义)。没有任何字符的编码是其它字符编码的子串,或是其它编码序列的字串,因此搜索一个字符时只要搜索它的字节编码序列即可,不用担心前后的上下文会对搜索结果产生干扰。同时UTF8编码的顺序和Unicode码点的顺序一致,因此可以直接排序UTF8编码序列。同时因为没有嵌入的NUL(0)字节,可以很好地兼容那些使用NUL作为字符串结尾的编程语言。
Go语言的源文件采用UTF8编码,并且Go语言处理UTF8编码的文本也很出色。unicode包提供了诸多处理rune字符相关功能的函数(比如区分字母和数字,或者是字母的大写和小写转换等),unicode/utf8包则提供了用于rune字符序列的UTF8编码和解码的功能。
有很多Unicode字符很难直接从键盘输入,并且还有很多字符有着相似的结构;有一些甚至是不可见的字符(译注:中文和日文就有很多相似但不同的字)。Go语言字符串面值中的Unicode转义字符让我们可以通过Unicode码点输入特殊的字符。有两种形式:\uhhhh对应16bit的码点值,\Uhhhhhhhh对应32bit的码点值,其中h是一个十六进制数字;一般很少需要使用32bit的形式。每一个对应码点的UTF8编码。例如:下面的字母串面值都表示相同的值:
"世界"
"\xe4\xb8\x96\xe7\x95\x8c"
"\u4e16\u754c"
"\U00004e16\U0000754c"
上面三个转义序列都为第一个字符串提供替代写法,但是它们的值都是相同的。
Unicode转义也可以使用在rune字符中。下面三个字符是等价的:
'世' '\u4e16' '\U00004e16'对于小于256的码点值可以写在一个十六进制转义字节中,例如\x41对应字符'A',但是对于更大的码点则必须使用\u或\U转义形式。因此,\xe4\xb8\x96并不是一个合法的rune字符,虽然这三个字节对应一个有效的UTF8编码的码点。
得益于UTF8编码优良的设计,诸多字符串操作都不需要解码操作。我们可以不用解码直接测试一个字符串是否是另一个字符串的前缀:
func HasPrefix(s, prefix string) bool {
	return len(s) >= len(prefix) && s[:len(prefix)] == prefix
}
或者是后缀测试:
func HasSuffix(s, suffix string) bool {
	return len(s) >= len(suffix) && s[len(s)-len(suffix):] == suffix
}
或者是包含子串测试:
func Contains(s, substr string) bool {
	for i := 0; i < len(s); i++ {
		if HasPrefix(s[i:], substr) {
			return true
		}
	}
	return false
}
对于UTF8编码后文本的处理和原始的字节处理逻辑是一样的。但是对应很多其它编码则并不是这样的。(上面的函数都来自strings字符串处理包,真实的代码包含了一个用哈希技术优化的Contains 实现。)
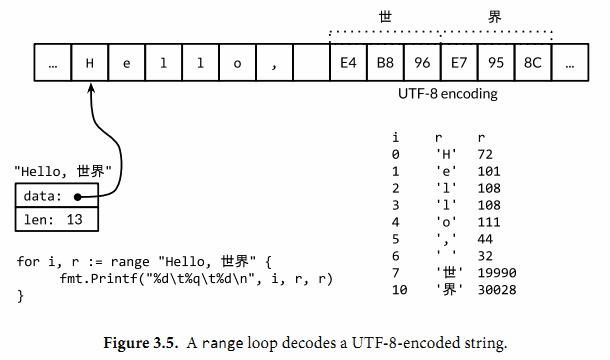
另一方面,如果我们真的关心每个Unicode字符,我们可以使用其它处理方式。考虑前面的第一个例子中的字符串,它混合了中西两种字符。图3.5展示了它的内存表示形式。字符串包含13个字节,以UTF8形式编码,但是只对应9个Unicode字符:
import "unicode/utf8"

s := "Hello, 世界"
fmt.Println(len(s))                    // "13"
fmt.Println(utf8.RuneCountInString(s)) // "9"
为了处理这些真实的字符,我们需要一个UTF8解码器。unicode/utf8包提供了该功能,我们可以这样使用:
for i := 0; i < len(s); {
	r, size := utf8.DecodeRuneInString(s[i:])
	fmt.Printf("%d\t%c\n", i, r)
	i += size
}
每一次调用DecodeRuneInString函数都返回一个r和长度,r对应字符本身,长度对应r采用UTF8编码后的编码字节数目。长度可以用于更新第i个字符在字符串中的字节索引位置。但是这种编码方式是笨拙的,我们需要更简洁的语法。幸运的是,Go语言的range循环在处理字符串的时候,会自动隐式解码UTF8字符串。下面的循环运行如图3.5所示;需要注意的是对于非ASCII,索引更新的步长将超过1个字节。
for i, r := range "Hello, 世界" {
	fmt.Printf("%d\t%q\t%d\n", i, r, r)
}
我们可以使用一个简单的循环来统计字符串中字符的数目,像这样:
n := 0
for _, _ = range s {
	n++
}
像其它形式的循环那样,我们也可以忽略不需要的变量:
n := 0
for range s {
	n++
}
或者我们可以直接调用utf8.RuneCountInString(s)函数。
正如我们前面提到的,文本字符串采用UTF8编码只是一种惯例,但是对于循环的真正字符串并不是一个惯例,这是正确的。如果用于循环的字符串只是一个普通的二进制数据,或者是含有错误编码的UTF8数据,将会发生什么呢?
每一个UTF8字符解码,不管是显式地调用utf8.DecodeRuneInString解码或是在range循环中隐式地解码,如果遇到一个错误的UTF8编码输入,将生成一个特别的Unicode字符\uFFFD,在印刷中这个符号通常是一个黑色六角或钻石形状,里面包含一个白色的问号"?"。当程序遇到这样的一个字符,通常是一个危险信号,说明输入并不是一个完美没有错误的UTF8字符串。
UTF8字符串作为交换格式是非常方便的,但是在程序内部采用rune序列可能更方便,因为rune大小一致,支持数组索引和方便切割。
将[]rune类型转换应用到UTF8编码的字符串,将返回字符串编码的Unicode码点序列:
// "program" in Japanese katakana
s := "プログラム"
fmt.Printf("% x\n", s) // "e3 83 97 e3 83 ad e3 82 b0 e3 83 a9 e3 83 a0"
r := []rune(s)
fmt.Printf("%x\n", r) // "[30d7 30ed 30b0 30e9 30e0]"(在第一个Printf中的% x参数用于在每个十六进制数字前插入一个空格。)
如果是将一个[]rune类型的Unicode字符slice或数组转为string,则对它们进行UTF8编码:
fmt.Println(string(r)) // "プログラム"将一个整数转型为字符串意思是生成以只包含对应Unicode码点字符的UTF8字符串:
fmt.Println(string(65))     // "A", not "65"
fmt.Println(string(0x4eac)) // "京"如果对应码点的字符是无效的,则用\uFFFD无效字符作为替换:
fmt.Println(string(1234567)) // "?"3.5.4. 字符串和Byte切片
标准库中有四个包对字符串处理尤为重要:bytes、strings、strconv和unicode包。strings包提供了许多如字符串的查询、替换、比较、截断、拆分和合并等功能。
bytes包也提供了很多类似功能的函数,但是针对和字符串有着相同结构的[]byte类型。因为字符串是只读的,因此逐步构建字符串会导致很多分配和复制。在这种情况下,使用bytes.Buffer类型将会更有效,稍后我们将展示。
strconv包提供了布尔型、整型数、浮点数和对应字符串的相互转换,还提供了双引号转义相关的转换。
unicode包提供了IsDigit、IsLetter、IsUpper和IsLower等类似功能,它们用于给字符分类。每个函数有一个单一的rune类型的参数,然后返回一个布尔值。而像ToUpper和ToLower之类的转换函数将用于rune字符的大小写转换。所有的这些函数都是遵循Unicode标准定义的字母、数字等分类规范。strings包也有类似的函数,它们是ToUpper和ToLower,将原始字符串的每个字符都做相应的转换,然后返回新的字符串。
下面例子的basename函数灵感源于Unix shell的同名工具。在我们实现的版本中,basename(s)将看起来像是系统路径的前缀删除,同时将看似文件类型的后缀名部分删除:
fmt.Println(basename("a/b/c.go")) // "c"
fmt.Println(basename("c.d.go"))   // "c.d"
fmt.Println(basename("abc"))      // "abc"
第一个版本并没有使用任何库,全部手工硬编码实现:
// basename removes directory components and a .suffix.
// e.g., a => a, a.go => a, a/b/c.go => c, a/b.c.go => b.c
func basename(s string) string {
	// Discard last '/' and everything before.
	for i := len(s) - 1; i >= 0; i-- {
		if s[i] == '/' {
			s = s[i+1:]
			break
		}
	}
	// Preserve everything before last '.'.
	for i := len(s) - 1; i >= 0; i-- {
		if s[i] == '.' {
			s = s[:i]
			break
		}
	}
	return s
}
这个简化版本使用了strings.LastIndex库函数:
func basename(s string) string {
	slash := strings.LastIndex(s, "/") // -1 if "/" not found
	s = s[slash+1:]
	if dot := strings.LastIndex(s, "."); dot >= 0 {
		s = s[:dot]
	}
	return s
}
path和path/filepath包提供了关于文件路径名更一般的函数操作。使用斜杠分隔路径可以在任何操作系统上工作。斜杠本身不应该用于文件名,但是在其他一些领域可能会用于文件名,例如URL路径组件。相比之下,path/filepath包则使用操作系统本身的路径规则,例如POSIX系统使用/foo/bar,而Microsoft Windows使用c:\foo\bar等。
让我们继续另一个字符串的例子。函数的功能是将一个表示整数值的字符串,每隔三个字符插入一个逗号分隔符,例如“12345”处理后成为“12,345”。这个版本只适用于整数类型;支持浮点数类型的留作练习。
// comma inserts commas in a non-negative decimal integer string.
func comma(s string) string {
	n := len(s)
	if n <= 3 {
		return s
	}
	return comma(s[:n-3]) + "," + s[n-3:]
}
输入comma函数的参数是一个字符串。如果输入字符串的长度小于或等于3的话,则不需要插入逗号分隔符。否则,comma函数将在最后三个字符前的位置将字符串切割为两个子串并插入逗号分隔符,然后通过递归调用自身来得出前面的子串。
一个字符串是包含只读字节的数组,一旦创建,是不可变的。相比之下,一个字节slice的元素则可以自由地修改。
字符串和字节slice之间可以相互转换:
s := "abc"
b := []byte(s)
s2 := string(b)
从概念上讲,一个[]byte(s)转换是分配了一个新的字节数组用于保存字符串数据的拷贝,然后引用这个底层的字节数组。编译器的优化可以避免在一些场景下分配和复制字符串数据,但总的来说需要确保在变量b被修改的情况下,原始的s字符串也不会改变。将一个字节slice转换到字符串的string(b)操作则是构造一个字符串拷贝,以确保s2字符串是只读的。
为了避免转换中不必要的内存分配,bytes包和strings同时提供了许多实用函数。下面是strings包中的六个函数:
func Contains(s, substr string) bool
func Count(s, sep string) int
func Fields(s string) []string
func HasPrefix(s, prefix string) bool
func Index(s, sep string) int
func Join(a []string, sep string) string
bytes包中也对应的六个函数:
func Contains(b, subslice []byte) bool
func Count(s, sep []byte) int
func Fields(s []byte) [][]byte
func HasPrefix(s, prefix []byte) bool
func Index(s, sep []byte) int
func Join(s [][]byte, sep []byte) []byte
它们之间唯一的区别是字符串类型参数被替换成了字节slice类型的参数。
bytes包还提供了Buffer类型用于字节slice的缓存。一个Buffer开始是空的,但是随着string、byte或[]byte等类型数据的写入可以动态增长,一个bytes.Buffer变量并不需要初始化,因为零值也是有效的:
// intsToString is like fmt.Sprint(values) but adds commas.
func intsToString(values []int) string {
	var buf bytes.Buffer
	buf.WriteByte('[')
	for i, v := range values {
		if i > 0 {
			buf.WriteString(", ")
		}
		fmt.Fprintf(&buf, "%d", v)
	}
	buf.WriteByte(']')
	return buf.String()
}

func main() {
	fmt.Println(intsToString([]int{1, 2, 3})) // "[1, 2, 3]"
}
当向bytes.Buffer添加任意字符的UTF8编码时,最好使用bytes.Buffer的WriteRune方法,但是WriteByte方法对于写入类似'['和']'等ASCII字符则会更加有效。
bytes.Buffer类型有着很多实用的功能,我们在第七章讨论接口时将会涉及到,我们将看看如何将它用作一个I/O的输入和输出对象,例如当做Fprintf的io.Writer输出对象,或者当作io.Reader类型的输入源对象。
练习 3.10: 编写一个非递归版本的comma函数,使用bytes.Buffer代替字符串链接操作。
练习 3.11: 完善comma函数,以支持浮点数处理和一个可选的正负号的处理。
练习 3.12: 编写一个函数,判断两个字符串是否是相互打乱的,也就是说它们有着相同的字符,但是对应不同的顺序。
3.5.5. 字符串和数字的转换
除了字符串、字符、字节之间的转换,字符串和数值之间的转换也比较常见。由strconv包提供这类转换功能。
将一个整数转为字符串,一种方法是用fmt.Sprintf返回一个格式化的字符串;另一个方法是用strconv.Itoa(“整数到ASCII”):
x := 123
y := fmt.Sprintf("%d", x)
fmt.Println(y, strconv.Itoa(x)) // "123 123"
FormatInt和FormatUint函数可以用不同的进制来格式化数字:
fmt.Println(strconv.FormatInt(int64(x), 2)) // "1111011"fmt.Printf函数的%b、%d、%o和%x等参数提供功能往往比strconv包的Format函数方便很多,特别是在需要包含有附加额外信息的时候:
s := fmt.Sprintf("x=%b", x) // "x=1111011"如果要将一个字符串解析为整数,可以使用strconv包的Atoi或ParseInt函数,还有用于解析无符号整数的ParseUint函数:
x, err := strconv.Atoi("123")             // x is an int
y, err := strconv.ParseInt("123", 10, 64) // base 10, up to 64 bits
ParseInt函数的第三个参数是用于指定整型数的大小;例如16表示int16,0则表示int。在任何情况下,返回的结果y总是int64类型,你可以通过强制类型转换将它转为更小的整数类型。
有时候也会使用fmt.Scanf来解析输入的字符串和数字,特别是当字符串和数字混合在一行的时候,它可以灵活处理不完整或不规则的输入。
3.6. 常量
常量表达式的值在编译期计算,而不是在运行期。每种常量的潜在类型都是基础类型:boolean、string或数字。
一个常量的声明语句定义了常量的名字,和变量的声明语法类似,常量的值不可修改,这样可以防止在运行期被意外或恶意的修改。例如,常量比变量更适合用于表达像π之类的数学常数,因为它们的值不会发生变化:
const pi = 3.14159 // approximately; math.Pi is a better approximation和变量声明一样,可以批量声明多个常量;这比较适合声明一组相关的常量:
const (
	e  = 2.71828182845904523536028747135266249775724709369995957496696763
	pi = 3.14159265358979323846264338327950288419716939937510582097494459
)
所有常量的运算都可以在编译期完成,这样可以减少运行时的工作,也方便其他编译优化。当操作数是常量时,一些运行时的错误也可以在编译时被发现,例如整数除零、字符串索引越界、任何导致无效浮点数的操作等。
常量间的所有算术运算、逻辑运算和比较运算的结果也是常量,对常量的类型转换操作或以下函数调用都是返回常量结果:len、cap、real、imag、complex和unsafe.Sizeof(§13.1)。
因为它们的值是在编译期就确定的,因此常量可以是构成类型的一部分,例如用于指定数组类型的长度:
const IPv4Len = 4

// parseIPv4 parses an IPv4 address (d.d.d.d).
func parseIPv4(s string) IP {
	var p [IPv4Len]byte
	// ...
}
一个常量的声明也可以包含一个类型和一个值,但是如果没有显式指明类型,那么将从右边的表达式推断类型。在下面的代码中,time.Duration是一个命名类型,底层类型是int64,time.Minute是对应类型的常量。下面声明的两个常量都是time.Duration类型,可以通过%T参数打印类型信息:
const noDelay time.Duration = 0
const timeout = 5 * time.Minute
fmt.Printf("%T %[1]v\n", noDelay)     // "time.Duration 0"
fmt.Printf("%T %[1]v\n", timeout)     // "time.Duration 5m0s"
fmt.Printf("%T %[1]v\n", time.Minute) // "time.Duration 1m0s"
如果是批量声明的常量,除了第一个外其它的常量右边的初始化表达式都可以省略,如果省略初始化表达式则表示使用前面常量的初始化表达式写法,对应的常量类型也一样的。例如:
const (
	a = 1
	b
	c = 2
	d
)

fmt.Println(a, b, c, d) // "1 1 2 2"
如果只是简单地复制右边的常量表达式,其实并没有太实用的价值。但是它可以带来其它的特性,那就是iota常量生成器语法。
3.6.1. iota 常量生成器
常量声明可以使用iota常量生成器初始化,它用于生成一组以相似规则初始化的常量,但是不用每行都写一遍初始化表达式。在一个const声明语句中,在第一个声明的常量所在的行,iota将会被置为0,然后在每一个有常量声明的行加一。
下面是来自time包的例子,它首先定义了一个Weekday命名类型,然后为一周的每天定义了一个常量,从周日0开始。在其它编程语言中,这种类型一般被称为枚举类型。
type Weekday int

const (
	Sunday Weekday = iota
	Monday
	Tuesday
	Wednesday
	Thursday
	Friday
	Saturday
)
周日将对应0,周一为1,如此等等。
我们也可以在复杂的常量表达式中使用iota,下面是来自net包的例子,用于给一个无符号整数的最低5bit的每个bit指定一个名字:
type Flags uint

const (
	FlagUp Flags = 1 << iota // is up
	FlagBroadcast            // supports broadcast access capability
	FlagLoopback             // is a loopback interface
	FlagPointToPoint         // belongs to a point-to-point link
	FlagMulticast            // supports multicast access capability
)
随着iota的递增,每个常量对应表达式1 << iota,是连续的2的幂,分别对应一个bit位置。使用这些常量可以用于测试、设置或清除对应的bit位的值:
func IsUp(v Flags) bool     { return v&FlagUp == FlagUp }
func TurnDown(v *Flags)     { *v &^= FlagUp }
func SetBroadcast(v *Flags) { *v |= FlagBroadcast }
func IsCast(v Flags) bool   { return v&(FlagBroadcast|FlagMulticast) != 0 }

func main() {
	var v Flags = FlagMulticast | FlagUp
	fmt.Printf("%b %t\n", v, IsUp(v)) // "10001 true"
	TurnDown(&v)
	fmt.Printf("%b %t\n", v, IsUp(v)) // "10000 false"
	SetBroadcast(&v)
	fmt.Printf("%b %t\n", v, IsUp(v))   // "10010 false"
	fmt.Printf("%b %t\n", v, IsCast(v)) // "10010 true"
}
下面是一个更复杂的例子,每个常量都是1024的幂:
const (
	_ = 1 << (10 * iota)
	KiB // 1024
	MiB // 1048576
	GiB // 1073741824
	TiB // 1099511627776             (exceeds 1 << 32)
	PiB // 1125899906842624
	EiB // 1152921504606846976
	ZiB // 1180591620717411303424    (exceeds 1 << 64)
	YiB // 1208925819614629174706176
)
不过iota常量生成规则也有其局限性。例如,它并不能用于产生1000的幂(KB、MB等),因为Go语言并没有计算幂的运算符。
练习 3.13: 编写KB、MB的常量声明,然后扩展到YB。
3.6.2. 无类型常量
Go语言的常量有个不同寻常之处。虽然一个常量可以有任意一个确定的基础类型,例如int或float64,或者是类似time.Duration这样命名的基础类型,但是许多常量并没有一个明确的基础类型。编译器为这些没有明确基础类型的数字常量提供比基础类型更高精度的算术运算;你可以认为至少有256bit的运算精度。这里有六种未明确类型的常量类型,分别是无类型的布尔型、无类型的整数、无类型的字符、无类型的浮点数、无类型的复数、无类型的字符串。
通过延迟明确常量的具体类型,无类型的常量不仅可以提供更高的运算精度,而且可以直接用于更多的表达式而不需要显式的类型转换。例如,例子中的ZiB和YiB的值已经超出任何Go语言中整数类型能表达的范围,但是它们依然是合法的常量,而且像下面的常量表达式依然有效(译注:YiB/ZiB是在编译期计算出来的,并且结果常量是1024,是Go语言int变量能有效表示的):
fmt.Println(YiB/ZiB) // "1024"另一个例子,math.Pi无类型的浮点数常量,可以直接用于任意需要浮点数或复数的地方:
var x float32 = math.Pi
var y float64 = math.Pi
var z complex128 = math.Pi
如果math.Pi被确定为特定类型,比如float64,那么结果精度可能会不一样,同时对于需要float32或complex128类型值的地方则会强制需要一个明确的类型转换:
const Pi64 float64 = math.Pi

var x float32 = float32(Pi64)
var y float64 = Pi64
var z complex128 = complex128(Pi64)对于常量面值,不同的写法可能会对应不同的类型。例如0、0.0、0i和\u0000虽然有着相同的常量值,但是它们分别对应无类型的整数、无类型的浮点数、无类型的复数和无类型的字符等不同的常量类型。同样,true和false也是无类型的布尔类型,字符串面值常量是无类型的字符串类型。
前面说过除法运算符/会根据操作数的类型生成对应类型的结果。因此,不同写法的常量除法表达式可能对应不同的结果:
var f float64 = 212
fmt.Println((f - 32) * 5 / 9)     // "100"; (f - 32) * 5 is a float64
fmt.Println(5 / 9 * (f - 32))     // "0";   5/9 is an untyped integer, 0
fmt.Println(5.0 / 9.0 * (f - 32)) // "100"; 5.0/9.0 is an untyped float
只有常量可以是无类型的。当一个无类型的常量被赋值给一个变量的时候,就像下面的第一行语句,或者出现在有明确类型的变量声明的右边,如下面的其余三行语句,无类型的常量将会被隐式转换为对应的类型,如果转换合法的话。
var f float64 = 3 + 0i // untyped complex -> float64
f = 2                  // untyped integer -> float64
f = 1e123              // untyped floating-point -> float64
f = 'a'                // untyped rune -> float64
上面的语句相当于:
var f float64 = float64(3 + 0i)
f = float64(2)
f = float64(1e123)
f = float64('a')
无论是隐式或显式转换,将一种类型转换为另一种类型都要求目标可以表示原始值。对于浮点数和复数,可能会有舍入处理:
const (
	deadbeef = 0xdeadbeef // untyped int with value 3735928559
	a = uint32(deadbeef)  // uint32 with value 3735928559
	b = float32(deadbeef) // float32 with value 3735928576 (rounded up)
	c = float64(deadbeef) // float64 with value 3735928559 (exact)
	d = int32(deadbeef)   // compile error: constant overflows int32
	e = float64(1e309)    // compile error: constant overflows float64
	f = uint(-1)          // compile error: constant underflows uint
)
对于一个没有显式类型的变量声明(包括简短变量声明),常量的形式将隐式决定变量的默认类型,就像下面的例子:
i := 0      // untyped integer;        implicit int(0)
r := '\000' // untyped rune;           implicit rune('\000')
f := 0.0    // untyped floating-point; implicit float64(0.0)
c := 0i     // untyped complex;        implicit complex128(0i)
注意有一点不同:无类型整数常量转换为int,它的内存大小是不确定的,但是无类型浮点数和复数常量则转换为内存大小明确的float64和complex128。
如果不知道浮点数类型的内存大小是很难写出正确的数值算法的,因此Go语言不存在整型类似的不确定内存大小的浮点数和复数类型。
如果要给变量一个不同的类型,我们必须显式地将无类型的常量转化为所需的类型,或给声明的变量指定明确的类型,像下面例子这样:
var i = int8(0)
var i int8 = 0
当尝试将这些无类型的常量转为一个接口值时(见第7章),这些默认类型将显得尤为重要,因为要靠它们明确接口对应的动态类型。
fmt.Printf("%T\n", 0)      // "int"
fmt.Printf("%T\n", 0.0)    // "float64"
fmt.Printf("%T\n", 0i)     // "complex128"
fmt.Printf("%T\n", '\000') // "int32" (rune)
现在我们已经讲述了Go语言中全部的基础数据类型。下一步将演示如何用基础数据类型组合成数组或结构体等复杂数据类型,然后构建用于解决实际编程问题的数据结构,这将是第四章的讨论主题。
4.1. 数组
数组是一个由固定长度的特定类型元素组成的序列,一个数组可以由零个或多个元素组成。因为数组的长度是固定的,因此在Go语言中很少直接使用数组。和数组对应的类型是Slice(切片),它是可以增长和收缩的动态序列,slice功能也更灵活,但是要理解slice工作原理的话需要先理解数组。
数组的每个元素可以通过索引下标来访问,索引下标的范围是从0开始到数组长度减1的位置。内置的len函数将返回数组中元素的个数。
var a [3]int             // array of 3 integers
fmt.Println(a[0])        // print the first element
fmt.Println(a[len(a)-1]) // print the last element, a[2]

// Print the indices and elements.
for i, v := range a {
	fmt.Printf("%d %d\n", i, v)
}

// Print the elements only.
for _, v := range a {
	fmt.Printf("%d\n", v)
}
默认情况下,数组的每个元素都被初始化为元素类型对应的零值,对于数字类型来说就是0。我们也可以使用数组字面值语法用一组值来初始化数组:
var q [3]int = [3]int{1, 2, 3}
var r [3]int = [3]int{1, 2}
fmt.Println(r[2]) // "0"
在数组字面值中,如果在数组的长度位置出现的是“...”省略号,则表示数组的长度是根据初始化值的个数来计算。因此,上面q数组的定义可以简化为
q := [...]int{1, 2, 3}
fmt.Printf("%T\n", q) // "[3]int"
数组的长度是数组类型的一个组成部分,因此[3]int和[4]int是两种不同的数组类型。数组的长度必须是常量表达式,因为数组的长度需要在编译阶段确定。
q := [3]int{1, 2, 3}
q = [4]int{1, 2, 3, 4} // compile error: cannot assign [4]int to [3]int
我们将会发现,数组、slice、map和结构体字面值的写法都很相似。上面的形式是直接提供顺序初始化值序列,但是也可以指定一个索引和对应值列表的方式初始化,就像下面这样:
type Currency int

const (
	USD Currency = iota // 美元
	EUR                 // 欧元
	GBP                 // 英镑
	RMB                 // 人民币
)

symbol := [...]string{USD: "$", EUR: "€", GBP: "£", RMB: "¥"}

fmt.Println(RMB, symbol[RMB]) // "3 ¥"
在这种形式的数组字面值形式中,初始化索引的顺序是无关紧要的,而且没用到的索引可以省略,和前面提到的规则一样,未指定初始值的元素将用零值初始化。例如,
r := [...]int{99: -1}定义了一个含有100个元素的数组r,最后一个元素被初始化为-1,其它元素都是用0初始化。
如果一个数组的元素类型是可以相互比较的,那么数组类型也是可以相互比较的,这时候我们可以直接通过==比较运算符来比较两个数组,只有当两个数组的所有元素都是相等的时候数组才是相等的。不相等比较运算符!=遵循同样的规则。
a := [2]int{1, 2}
b := [...]int{1, 2}
c := [2]int{1, 3}
fmt.Println(a == b, a == c, b == c) // "true false false"
d := [3]int{1, 2}
fmt.Println(a == d) // compile error: cannot compare [2]int == [3]int
作为一个真实的例子,crypto/sha256包的Sum256函数对一个任意的字节slice类型的数据生成一个对应的消息摘要。消息摘要有256bit大小,因此对应[32]byte数组类型。如果两个消息摘要是相同的,那么可以认为两个消息本身也是相同(译注:理论上有HASH码碰撞的情况,但是实际应用可以基本忽略);如果消息摘要不同,那么消息本身必然也是不同的。下面的例子用SHA256算法分别生成“x”和“X”两个信息的摘要:
import "crypto/sha256"

func main() {
	c1 := sha256.Sum256([]byte("x"))
	c2 := sha256.Sum256([]byte("X"))
	fmt.Printf("%x\n%x\n%t\n%T\n", c1, c2, c1 == c2, c1)
	// Output:
	// 2d711642b726b04401627ca9fbac32f5c8530fb1903cc4db02258717921a4881
	// 4b68ab3847feda7d6c62c1fbcbeebfa35eab7351ed5e78f4ddadea5df64b8015
	// false
	// [32]uint8
}
上面例子中,两个消息虽然只有一个字符的差异,但是生成的消息摘要则几乎有一半的bit位是不相同的。需要注意Printf函数的%x副词参数,它用于指定以十六进制的格式打印数组或slice全部的元素,%t副词参数是用于打印布尔型数据,%T副词参数是用于显示一个值对应的数据类型。
当调用一个函数的时候,函数的每个调用参数将会被赋值给函数内部的参数变量,所以函数参数变量接收的是一个复制的副本,并不是原始调用的变量。因为函数参数传递的机制导致传递大的数组类型将是低效的,并且对数组参数的任何的修改都是发生在复制的数组上,并不能直接修改调用时原始的数组变量。在这个方面,Go语言对待数组的方式和其它很多编程语言不同,其它编程语言可能会隐式地将数组作为引用或指针对象传入被调用的函数。
当然,我们可以显式地传入一个数组指针,那样的话函数通过指针对数组的任何修改都可以直接反馈到调用者。下面的函数用于给[32]byte类型的数组清零:
func zero(ptr *[32]byte) {
	for i := range ptr {
		ptr[i] = 0
	}
}
其实数组字面值[32]byte{}就可以生成一个32字节的数组。而且每个数组的元素都是零值初始化,也就是0。因此,我们可以将上面的zero函数写的更简洁一点:
func zero(ptr *[32]byte) {
	*ptr = [32]byte{}
}
虽然通过指针来传递数组参数是高效的,而且也允许在函数内部修改数组的值,但是数组依然是僵化的类型,因为数组的类型包含了僵化的长度信息。上面的zero函数并不能接收指向[16]byte类型数组的指针,而且也没有任何添加或删除数组元素的方法。由于这些原因,除了像SHA256这类需要处理特定大小数组的特例外,数组依然很少用作函数参数;相反,我们一般使用slice来替代数组。
4.2. Slice
Slice(切片)代表变长的序列,序列中每个元素都有相同的类型。一个slice类型一般写作[]T,其中T代表slice中元素的类型;slice的语法和数组很像,只是没有固定长度而已。
数组和slice之间有着紧密的联系。一个slice是一个轻量级的数据结构,提供了访问数组子序列(或者全部)元素的功能,而且slice的底层确实引用一个数组对象。一个slice由三个部分构成:指针、长度和容量。指针指向第一个slice元素对应的底层数组元素的地址,要注意的是slice的第一个元素并不一定就是数组的第一个元素。长度对应slice中元素的数目;长度不能超过容量,容量一般是从slice的开始位置到底层数据的结尾位置。内置的len和cap函数分别返回slice的长度和容量。
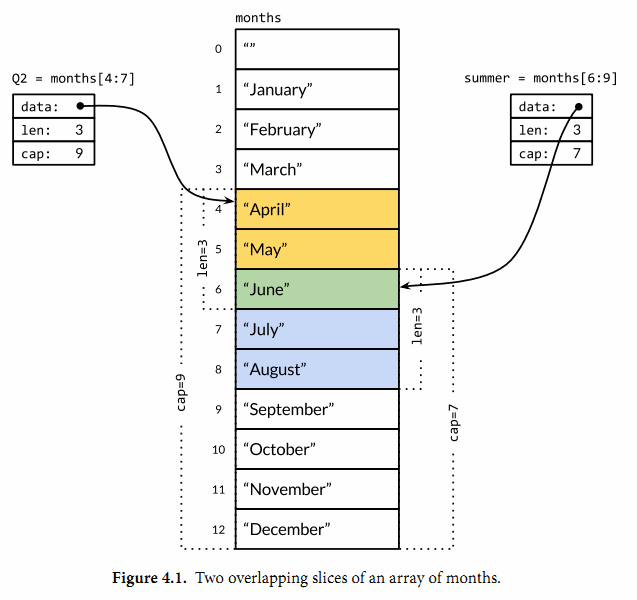
多个slice之间可以共享底层的数据,并且引用的数组部分区间可能重叠。图4.1显示了表示一年中每个月份名字的字符串数组,还有重叠引用了该数组的两个slice。数组这样定义
months := [...]string{1: "January", /* ... */, 12: "December"}因此一月份是months[1],十二月份是months[12]。通常,数组的第一个元素从索引0开始,但是月份一般是从1开始的,因此我们声明数组时直接跳过第0个元素,第0个元素会被自动初始化为空字符串。
slice的切片操作s[i:j],其中0 ≤ i≤ j≤ cap(s),用于创建一个新的slice,引用s的从第i个元素开始到第j-1个元素的子序列。新的slice将只有j-i个元素。如果i位置的索引被省略的话将使用0代替,如果j位置的索引被省略的话将使用len(s)代替。因此,months[1:13]切片操作将引用全部有效的月份,和months[1:]操作等价;months[:]切片操作则是引用整个数组。让我们分别定义表示第二季度和北方夏天月份的slice,它们有重叠部分:
Q2 := months[4:7]
summer := months[6:9]
fmt.Println(Q2)     // ["April" "May" "June"]
fmt.Println(summer) // ["June" "July" "August"]
两个slice都包含了六月份,下面的代码是一个包含相同月份的测试(性能较低):
for _, s := range summer {
	for _, q := range Q2 {
		if s == q {
			fmt.Printf("%s appears in both\n", s)
		}
	}
}
如果切片操作超出cap(s)的上限将导致一个panic异常,但是超出len(s)则是意味着扩展了slice,因为新slice的长度会变大:
fmt.Println(summer[:20]) // panic: out of range

endlessSummer := summer[:5] // extend a slice (within capacity)
fmt.Println(endlessSummer)  // "[June July August September October]"
另外,字符串的切片操作和[]byte字节类型切片的切片操作是类似的。都写作x[m:n],并且都是返回一个原始字节序列的子序列,底层都是共享之前的底层数组,因此这种操作都是常量时间复杂度。x[m:n]切片操作对于字符串则生成一个新字符串,如果x是[]byte的话则生成一个新的[]byte。
因为slice值包含指向第一个slice元素的指针,因此向函数传递slice将允许在函数内部修改底层数组的元素。换句话说,复制一个slice只是对底层的数组创建了一个新的slice别名(§2.3.2)。下面的reverse函数在原内存空间将[]int类型的slice反转,而且它可以用于任意长度的slice。
// reverse reverses a slice of ints in place.
func reverse(s []int) {
	for i, j := 0, len(s)-1; i < j; i, j = i+1, j-1 {
		s[i], s[j] = s[j], s[i]
	}
}
这里我们反转数组的应用:
a := [...]int{0, 1, 2, 3, 4, 5}
reverse(a[:])
fmt.Println(a) // "[5 4 3 2 1 0]"
一种将slice元素循环向左旋转n个元素的方法是三次调用reverse反转函数,第一次是反转开头的n个元素,然后是反转剩下的元素,最后是反转整个slice的元素。(如果是向右循环旋转,则将第三个函数调用移到第一个调用位置就可以了。)
s := []int{0, 1, 2, 3, 4, 5}
// Rotate s left by two positions.
reverse(s[:2])
reverse(s[2:])
reverse(s)
fmt.Println(s) // "[2 3 4 5 0 1]"
要注意的是slice类型的变量s和数组类型的变量a的初始化语法的差异。slice和数组的字面值语法很类似,它们都是用花括弧包含一系列的初始化元素,但是对于slice并没有指明序列的长度。这会隐式地创建一个合适大小的数组,然后slice的指针指向底层的数组。就像数组字面值一样,slice的字面值也可以按顺序指定初始化值序列,或者是通过索引和元素值指定,或者用两种风格的混合语法初始化。
和数组不同的是,slice之间不能比较,因此我们不能使用==操作符来判断两个slice是否含有全部相等元素。不过标准库提供了高度优化的bytes.Equal函数来判断两个字节型slice是否相等([]byte),但是对于其他类型的slice,我们必须自己展开每个元素进行比较:
func equal(x, y []string) bool {
	if len(x) != len(y) {
		return false
	}
	for i := range x {
		if x[i] != y[i] {
			return false
		}
	}
	return true
}
上面关于两个slice的深度相等测试,运行的时间并不比支持==操作的数组或字符串更多,但是为何slice不直接支持比较运算符呢?这方面有两个原因。第一个原因,一个slice的元素是间接引用的,一个slice甚至可以包含自身(译注:当slice声明为[]interface{}时,slice的元素可以是自身)。虽然有很多办法处理这种情形,但是没有一个是简单有效的。
第二个原因,因为slice的元素是间接引用的,一个固定的slice值(译注:指slice本身的值,不是元素的值)在不同的时刻可能包含不同的元素,因为底层数组的元素可能会被修改。而例如Go语言中map的key只做简单的浅拷贝,它要求key在整个生命周期内保持不变性(译注:例如slice扩容,就会导致其本身的值/地址变化)。而用深度相等判断的话,显然在map的key这种场合不合适。对于像指针或chan之类的引用类型,相等测试可以判断两个是否是引用相同的对象。一个针对slice的浅相等测试的操作符可能是有一定用处的,也能临时解决map类型的key问题,但是slice和数组不同的相等测试行为会让人困惑。因此,安全的做法是直接禁止slice之间的比较操作。
slice唯一合法的比较操作是和nil比较,例如:
if summer == nil { /* ... */ }一个零值的slice等于nil。一个nil值的slice并没有底层数组。一个nil值的slice的长度和容量都是0,但是也有非nil值的slice的长度和容量也是0的,例如[]int{}或make([]int, 3)[3:]。与任意类型的nil值一样,我们可以用[]int(nil)类型转换表达式来生成一个对应类型slice的nil值。
var s []int    // len(s) == 0, s == nil
s = nil        // len(s) == 0, s == nil
s = []int(nil) // len(s) == 0, s == nil
s = []int{}    // len(s) == 0, s != nil
如果你需要测试一个slice是否是空的,使用len(s) == 0来判断,而不应该用s == nil来判断。除了和nil相等比较外,一个nil值的slice的行为和其它任意0长度的slice一样;例如reverse(nil)也是安全的。除了文档已经明确说明的地方,所有的Go语言函数应该以相同的方式对待nil值的slice和0长度的slice。
内置的make函数创建一个指定元素类型、长度和容量的slice。容量部分可以省略,在这种情况下,容量将等于长度。
make([]T, len)
make([]T, len, cap) // same as make([]T, cap)[:len]
在底层,make创建了一个匿名的数组变量,然后返回一个slice;只有通过返回的slice才能引用底层匿名的数组变量。在第一种语句中,slice是整个数组的view。在第二个语句中,slice只引用了底层数组的前len个元素,但是容量将包含整个的数组。额外的元素是留给未来的增长用的。
4.2.1. append函数
内置的append函数用于向slice追加元素:
var runes []rune
for _, r := range "Hello, 世界" {
	runes = append(runes, r)
}
fmt.Printf("%q\n", runes) // "['H' 'e' 'l' 'l' 'o' ',' ' ' '世' '界']"
在循环中使用append函数构建一个由九个rune字符构成的slice,当然对应这个特殊的问题我们可以通过Go语言内置的[]rune("Hello, 世界")转换操作完成。
append函数对于理解slice底层是如何工作的非常重要,所以让我们仔细查看究竟是发生了什么。下面是第一个版本的appendInt函数,专门用于处理[]int类型的slice:
func appendInt(x []int, y int) []int {
	var z []int
	zlen := len(x) + 1
	if zlen <= cap(x) {
		// There is room to grow.  Extend the slice.
		z = x[:zlen]
	} else {
		// There is insufficient space.  Allocate a new array.
		// Grow by doubling, for amortized linear complexity.
		zcap := zlen
		if zcap < 2*len(x) {
			zcap = 2 * len(x)
		}
		z = make([]int, zlen, zcap)
		copy(z, x) // a built-in function; see text
	}
	z[len(x)] = y
	return z
}
每次调用appendInt函数,必须先检测slice底层数组是否有足够的容量来保存新添加的元素。如果有足够空间的话,直接扩展slice(依然在原有的底层数组之上),将新添加的y元素复制到新扩展的空间,并返回slice。因此,输入的x和输出的z共享相同的底层数组。
如果没有足够的增长空间的话,appendInt函数则会先分配一个足够大的slice用于保存新的结果,先将输入的x复制到新的空间,然后添加y元素。结果z和输入的x引用的将是不同的底层数组。
虽然通过循环复制元素更直接,不过内置的copy函数可以方便地将一个slice复制另一个相同类型的slice。copy函数的第一个参数是要复制的目标slice,第二个参数是源slice,目标和源的位置顺序和dst = src赋值语句是一致的。两个slice可以共享同一个底层数组,甚至有重叠也没有问题。copy函数将返回成功复制的元素的个数(我们这里没有用到),等于两个slice中较小的长度,所以我们不用担心覆盖会超出目标slice的范围。
为了提高内存使用效率,新分配的数组一般略大于保存x和y所需要的最低大小。通过在每次扩展数组时直接将长度翻倍从而避免了多次内存分配,也确保了添加单个元素操作的平均时间是一个常数时间。这个程序演示了效果:
func main() {
	var x, y []int
	for i := 0; i < 10; i++ {
		y = appendInt(x, i)
		fmt.Printf("%d cap=%d\t%v\n", i, cap(y), y)
		x = y
	}
}
每一次容量的变化都会导致重新分配内存和copy操作:
0  cap=1    [0]
1  cap=2    [0 1]
2  cap=4    [0 1 2]
3  cap=4    [0 1 2 3]
4  cap=8    [0 1 2 3 4]
5  cap=8    [0 1 2 3 4 5]
6  cap=8    [0 1 2 3 4 5 6]
7  cap=8    [0 1 2 3 4 5 6 7]
8  cap=16   [0 1 2 3 4 5 6 7 8]
9  cap=16   [0 1 2 3 4 5 6 7 8 9]
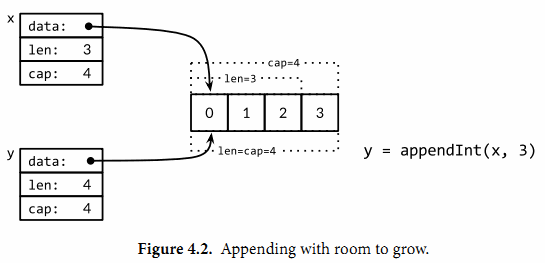
让我们仔细查看i=3次的迭代。当时x包含了[0 1 2]三个元素,但是容量是4,因此可以简单将新的元素添加到末尾,不需要新的内存分配。然后新的y的长度和容量都是4,并且和x引用着相同的底层数组,如图4.2所示。
在下一次迭代时i=4,现在没有新的空余的空间了,因此appendInt函数分配一个容量为8的底层数组,将x的4个元素[0 1 2 3]复制到新空间的开头,然后添加新的元素i,新元素的值是4。新的y的长度是5,容量是8;后面有3个空闲的位置,三次迭代都不需要分配新的空间。当前迭代中,y和x是对应不同底层数组的view。这次操作如图4.3所示。
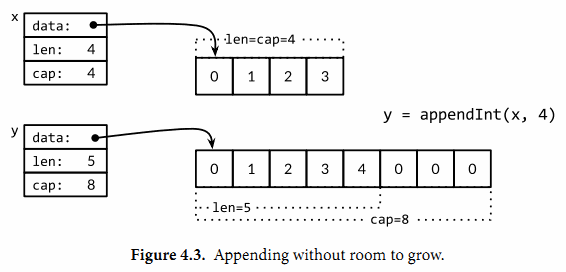
内置的append函数可能使用比appendInt更复杂的内存扩展策略。因此,通常我们并不知道append调用是否导致了内存的重新分配,因此我们也不能确认新的slice和原始的slice是否引用的是相同的底层数组空间。同样,我们不能确认在原先的slice上的操作是否会影响到新的slice。因此,通常是将append返回的结果直接赋值给输入的slice变量:
runes = append(runes, r)更新slice变量不仅对调用append函数是必要的,实际上对应任何可能导致长度、容量或底层数组变化的操作都是必要的。要正确地使用slice,需要记住尽管底层数组的元素是间接访问的,但是slice对应结构体本身的指针、长度和容量部分是直接访问的。要更新这些信息需要像上面例子那样一个显式的赋值操作。从这个角度看,slice并不是一个纯粹的引用类型,它实际上是一个类似下面结构体的聚合类型:
type IntSlice struct {
	ptr      *int
	len, cap int
}
我们的appendInt函数每次只能向slice追加一个元素,但是内置的append函数则可以追加多个元素,甚至追加一个slice。
var x []int
x = append(x, 1)
x = append(x, 2, 3)
x = append(x, 4, 5, 6)
x = append(x, x...) // append the slice x
fmt.Println(x)      // "[1 2 3 4 5 6 1 2 3 4 5 6]"
通过下面的小修改,我们可以达到append函数类似的功能。其中在appendInt函数参数中的最后的“...”省略号表示接收变长的参数为slice。我们将在5.7节详细解释这个特性。
func appendInt(x []int, y ...int) []int {
	var z []int
	zlen := len(x) + len(y)
	// ...expand z to at least zlen...
	copy(z[len(x):], y)
	return z
}
为了避免重复,和前面相同的代码并没有显示。
4.2.2. Slice内存技巧
让我们看看更多的例子,比如旋转slice、反转slice或在slice原有内存空间修改元素。给定一个字符串列表,下面的nonempty函数将在原有slice内存空间之上返回不包含空字符串的列表:
// Nonempty is an example of an in-place slice algorithm.
package main

import "fmt"

// nonempty returns a slice holding only the non-empty strings.
// The underlying array is modified during the call.
func nonempty(strings []string) []string {
	i := 0
	for _, s := range strings {
		if s != "" {
			strings[i] = s
			i++
		}
	}
	return strings[:i]
}
比较微妙的地方是,输入的slice和输出的slice共享一个底层数组。这可以避免分配另一个数组,不过原来的数据将可能会被覆盖,正如下面两个打印语句看到的那样:
data := []string{"one", "", "three"}
fmt.Printf("%q\n", nonempty(data)) // `["one" "three"]`
fmt.Printf("%q\n", data) // `["one" "three" "three"]`因此我们通常会这样使用nonempty函数:data = nonempty(data)。
nonempty函数也可以使用append函数实现:
func nonempty2(strings []string) []string {
	out := strings[:0] // zero-length slice of original
	for _, s := range strings {
		if s != "" {
			out = append(out, s)
		}
	}
	return out
}
无论如何实现,以这种方式重用一个slice一般都要求最多为每个输入值产生一个输出值,事实上很多这类算法都是用来过滤或合并序列中相邻的元素。这种slice用法是比较复杂的技巧,虽然使用到了slice的一些技巧,但是对于某些场合是比较清晰和有效的。
一个slice可以用来模拟一个stack。最初给定的空slice对应一个空的stack,然后可以使用append函数将新的值压入stack:
stack = append(stack, v) // push vstack的顶部位置对应slice的最后一个元素:
top := stack[len(stack)-1] // top of stack通过收缩stack可以弹出栈顶的元素
stack = stack[:len(stack)-1] // pop要删除slice中间的某个元素并保存原有的元素顺序,可以通过内置的copy函数将后面的子slice向前依次移动一位完成:
func remove(slice []int, i int) []int {
	copy(slice[i:], slice[i+1:])
	return slice[:len(slice)-1]
}

func main() {
	s := []int{5, 6, 7, 8, 9}
	fmt.Println(remove(s, 2)) // "[5 6 8 9]"
}
如果删除元素后不用保持原来顺序的话,我们可以简单的用最后一个元素覆盖被删除的元素:
func remove(slice []int, i int) []int {
	slice[i] = slice[len(slice)-1]
	return slice[:len(slice)-1]
}

func main() {
	s := []int{5, 6, 7, 8, 9}
	fmt.Println(remove(s, 2)) // "[5 6 9 8]
}
4.3. Map
哈希表是一种巧妙并且实用的数据结构。它是一个无序的key/value对的集合,其中所有的key都是不同的,然后通过给定的key可以在常数时间复杂度内检索、更新或删除对应的value。
在Go语言中,一个map就是一个哈希表的引用,map类型可以写为map[K]V,其中K和V分别对应key和value。map中所有的key都有相同的类型,所有的value也有着相同的类型,但是key和value之间可以是不同的数据类型。其中K对应的key必须是支持==比较运算符的数据类型,所以map可以通过测试key是否相等来判断是否已经存在。虽然浮点数类型也是支持相等运算符比较的,但是将浮点数用做key类型则是一个坏的想法,正如第三章提到的,最坏的情况是可能出现的NaN和任何浮点数都不相等。对于V对应的value数据类型则没有任何的限制。
内置的make函数可以创建一个map:
ages := make(map[string]int) // mapping from strings to ints我们也可以用map字面值的语法创建map,同时还可以指定一些最初的key/value:
ages := map[string]int{
	"alice":   31,
	"charlie": 34,
}
这相当于
ages := make(map[string]int)
ages["alice"] = 31
ages["charlie"] = 34因此,另一种创建空的map的表达式是map[string]int{}。
Map中的元素通过key对应的下标语法访问:
ages["alice"] = 32
fmt.Println(ages["alice"]) // "32"
使用内置的delete函数可以删除元素:
delete(ages, "alice") // remove element ages["alice"]所有这些操作是安全的,即使这些元素不在map中也没有关系;如果一个查找失败将返回value类型对应的零值,例如,即使map中不存在“bob”下面的代码也可以正常工作,因为ages["bob"]失败时将返回0。
ages["bob"] = ages["bob"] + 1 // happy birthday!而且x += y和x++等简短赋值语法也可以用在map上,所以上面的代码可以改写成
ages["bob"] += 1更简单的写法
ages["bob"]++但是map中的元素并不是一个变量,因此我们不能对map的元素进行取址操作:
_ = &ages["bob"] // compile error: cannot take address of map element禁止对map元素取址的原因是map可能随着元素数量的增长而重新分配更大的内存空间,从而可能导致之前的地址无效。
要想遍历map中全部的key/value对的话,可以使用range风格的for循环实现,和之前的slice遍历语法类似。下面的迭代语句将在每次迭代时设置name和age变量,它们对应下一个键/值对:
for name, age := range ages {
	fmt.Printf("%s\t%d\n", name, age)
}
Map的迭代顺序是不确定的,并且不同的哈希函数实现可能导致不同的遍历顺序。在实践中,遍历的顺序是随机的,每一次遍历的顺序都不相同。这是故意的,每次都使用随机的遍历顺序可以强制要求程序不会依赖具体的哈希函数实现。如果要按顺序遍历key/value对,我们必须显式地对key进行排序,可以使用sort包的Strings函数对字符串slice进行排序。下面是常见的处理方式:
import "sort"

var names []string
for name := range ages {
	names = append(names, name)
}
sort.Strings(names)
for _, name := range names {
	fmt.Printf("%s\t%d\n", name, ages[name])
}
因为我们一开始就知道names的最终大小,因此给slice分配一个合适的大小将会更有效。下面的代码创建了一个空的slice,但是slice的容量刚好可以放下map中全部的key:
names := make([]string, 0, len(ages))在上面的第一个range循环中,我们只关心map中的key,所以我们忽略了第二个循环变量。在第二个循环中,我们只关心names中的名字,所以我们使用“_”空白标识符来忽略第一个循环变量,也就是迭代slice时的索引。
map类型的零值是nil,也就是没有引用任何哈希表。
var ages map[string]int
fmt.Println(ages == nil)    // "true"
fmt.Println(len(ages) == 0) // "true"
map上的大部分操作,包括查找、删除、len和range循环都可以安全工作在nil值的map上,它们的行为和一个空的map类似。但是向一个nil值的map存入元素将导致一个panic异常:
ages["carol"] = 21 // panic: assignment to entry in nil map在向map存数据前必须先创建map。
通过key作为索引下标来访问map将产生一个value。如果key在map中是存在的,那么将得到与key对应的value;如果key不存在,那么将得到value对应类型的零值,正如我们前面看到的ages["bob"]那样。这个规则很实用,但是有时候可能需要知道对应的元素是否真的是在map之中。例如,如果元素类型是一个数字,你可能需要区分一个已经存在的0,和不存在而返回零值的0,可以像下面这样测试:
age, ok := ages["bob"]
if !ok { /* "bob" is not a key in this map; age == 0. */ }
你会经常看到将这两个结合起来使用,像这样:
if age, ok := ages["bob"]; !ok { /* ... */ }在这种场景下,map的下标语法将产生两个值;第二个是一个布尔值,用于报告元素是否真的存在。布尔变量一般命名为ok,特别适合马上用于if条件判断部分。
和slice一样,map之间也不能进行相等比较;唯一的例外是和nil进行比较。要判断两个map是否包含相同的key和value,我们必须通过一个循环实现:
func equal(x, y map[string]int) bool {
	if len(x) != len(y) {
		return false
	}
	for k, xv := range x {
		if yv, ok := y[k]; !ok || yv != xv {
			return false
		}
	}
	return true
}
从例子中可以看到如何用!ok来区分元素不存在,与元素存在但为0的。我们不能简单地用xv != y[k]判断,那样会导致在判断下面两个map时产生错误的结果:
// True if equal is written incorrectly.
equal(map[string]int{"A": 0}, map[string]int{"B": 42})
Go语言中并没有提供一个set类型,但是map中的key也是不相同的,可以用map实现类似set的功能。为了说明这一点,下面的dedup程序读取多行输入,但是只打印第一次出现的行。(它是1.3节中出现的dup程序的变体。)dedup程序通过map来表示所有的输入行所对应的set集合,以确保已经在集合存在的行不会被重复打印。
func main() {
	seen := make(map[string]bool) // a set of strings
	input := bufio.NewScanner(os.Stdin)
	for input.Scan() {
		line := input.Text()
		if !seen[line] {
			seen[line] = true
			fmt.Println(line)
		}
	}

	if err := input.Err(); err != nil {
		fmt.Fprintf(os.Stderr, "dedup: %v\n", err)
		os.Exit(1)
	}
}Go程序员将这种忽略value的map当作一个字符串集合,并非所有map[string]bool类型value都是无关紧要的;有一些则可能会同时包含true和false的值。
有时候我们需要一个map或set的key是slice类型,但是map的key必须是可比较的类型,但是slice并不满足这个条件。不过,我们可以通过两个步骤绕过这个限制。第一步,定义一个辅助函数k,将slice转为map对应的string类型的key,确保只有x和y相等时k(x) == k(y)才成立。然后创建一个key为string类型的map,在每次对map操作时先用k辅助函数将slice转化为string类型。
下面的例子演示了如何使用map来记录提交相同的字符串列表的次数。它使用了fmt.Sprintf函数将字符串列表转换为一个字符串以用于map的key,通过%q参数忠实地记录每个字符串元素的信息:
var m = make(map[string]int)

func k(list []string) string { return fmt.Sprintf("%q", list) }

func Add(list []string)       { m[k(list)]++ }
func Count(list []string) int { return m[k(list)] }
使用同样的技术可以处理任何不可比较的key类型,而不仅仅是slice类型。这种技术对于想使用自定义key比较函数的时候也很有用,例如在比较字符串的时候忽略大小写。同时,辅助函数k(x)也不一定是字符串类型,它可以返回任何可比较的类型,例如整数、数组或结构体等。
这是map的另一个例子,下面的程序用于统计输入中每个Unicode码点出现的次数。虽然Unicode全部码点的数量巨大,但是出现在特定文档中的字符种类并没有多少,使用map可以用比较自然的方式来跟踪那些出现过的字符的次数。
// Charcount computes counts of Unicode characters.
package main

import (
	"bufio"
	"fmt"
	"io"
	"os"
	"unicode"
	"unicode/utf8"
)

func main() {
	counts := make(map[rune]int)    // counts of Unicode characters
	var utflen [utf8.UTFMax + 1]int // count of lengths of UTF-8 encodings
	invalid := 0                    // count of invalid UTF-8 characters

	in := bufio.NewReader(os.Stdin)
	for {
		r, n, err := in.ReadRune() // returns rune, nbytes, error
		if err == io.EOF {
			break
		}
		if err != nil {
			fmt.Fprintf(os.Stderr, "charcount: %v\n", err)
			os.Exit(1)
		}
		if r == unicode.ReplacementChar && n == 1 {
			invalid++
			continue
		}
		counts[r]++
		utflen[n]++
	}
	fmt.Printf("rune\tcount\n")
	for c, n := range counts {
		fmt.Printf("%q\t%d\n", c, n)
	}
	fmt.Print("\nlen\tcount\n")
	for i, n := range utflen {
		if i > 0 {
			fmt.Printf("%d\t%d\n", i, n)
		}
	}
	if invalid > 0 {
		fmt.Printf("\n%d invalid UTF-8 characters\n", invalid)
	}
}
ReadRune方法执行UTF-8解码并返回三个值:解码的rune字符的值,字符UTF-8编码后的长度,和一个错误值。我们可预期的错误值只有对应文件结尾的io.EOF。如果输入的是无效的UTF-8编码的字符,返回的将是unicode.ReplacementChar表示无效字符,并且编码长度是1。
charcount程序同时打印不同UTF-8编码长度的字符数目。对此,map并不是一个合适的数据结构;因为UTF-8编码的长度总是从1到utf8.UTFMax(最大是4个字节),使用数组将更有效。
作为一个实验,我们用charcount程序对英文版原稿的字符进行了统计。虽然大部分是英语,但是也有一些非ASCII字符。下面是排名前10的非ASCII字符:

下面是不同UTF-8编码长度的字符的数目:
len count
1   765391
2   60
3   70
4   0
Map的value类型也可以是一个聚合类型,比如是一个map或slice。在下面的代码中,graph 这个 map 的key类型是一个字符串,value类型map[string]bool代表一个字符串集合。从概念上讲,graph将一个字符串类型的key映射到一组相关的字符串集合,它们指向新的graph的key。
var graph = make(map[string]map[string]bool)

func addEdge(from, to string) {
	edges := graph[from]
	if edges == nil {
		edges = make(map[string]bool)
		graph[from] = edges
	}
	edges[to] = true
}

func hasEdge(from, to string) bool {
	return graph[from][to]
}
其中addEdge函数惰性初始化map是一个惯用方式,也就是说在每个值首次作为key时才初始化。hasEdge函数显示了如何让map的零值也能正常工作;即使from到to的边不存在,graph[from][to]依然可以返回一个有意义的结果。
4.4. 结构体
重要
结构体匿名类型
结构体是一种聚合的数据类型,是由零个或多个任意类型的值聚合成的实体。每个值称为结构体的成员。用结构体的经典案例是处理公司的员工信息,每个员工信息包含一个唯一的员工编号、员工的名字、家庭住址、出生日期、工作岗位、薪资、上级领导等等。所有的这些信息都需要绑定到一个实体中,可以作为一个整体单元被复制,作为函数的参数或返回值,或者是被存储到数组中,等等。
下面两个语句声明了一个叫Employee的命名的结构体类型,并且声明了一个Employee类型的变量dilbert:
type Employee struct {
	ID        int
	Name      string
	Address   string
	DoB       time.Time
	Position  string
	Salary    int
	ManagerID int
}

var dilbert Employee
dilbert结构体变量的成员可以通过点操作符访问,比如dilbert.Name和dilbert.DoB。因为dilbert是一个变量,它所有的成员也同样是变量,我们可以直接对每个成员赋值:
dilbert.Salary -= 5000 // demoted, for writing too few lines of code或者是对成员取地址,然后通过指针访问:
position := &dilbert.Position
*position = "Senior " + *position // promoted, for outsourcing to Elbonia
点操作符也可以和指向结构体的指针一起工作:
var employeeOfTheMonth *Employee = &dilbert
employeeOfTheMonth.Position += " (proactive team player)"
相当于下面语句
(*employeeOfTheMonth).Position += " (proactive team player)"下面的EmployeeByID函数将根据给定的员工ID返回对应的员工信息结构体的指针。我们可以使用点操作符来访问它里面的成员:
func EmployeeByID(id int) *Employee { /* ... */ }

fmt.Println(EmployeeByID(dilbert.ManagerID).Position) // "Pointy-haired boss"

id := dilbert.ID
EmployeeByID(id).Salary = 0 // fired for... no real reason后面的语句通过EmployeeByID返回的结构体指针更新了Employee结构体的成员。如果将EmployeeByID函数的返回值从*Employee指针类型改为Employee值类型,那么更新语句将不能编译通过,因为在赋值语句的左边并不确定是一个变量(译注:调用函数返回的是值,并不是一个可取地址的变量)。
通常一行对应一个结构体成员,成员的名字在前类型在后,不过如果相邻的成员类型如果相同的话可以被合并到一行,就像下面的Name和Address成员那样:
type Employee struct {
	ID            int
	Name, Address string
	DoB           time.Time
	Position      string
	Salary        int
	ManagerID     int
}
结构体成员的输入顺序也有重要的意义。我们也可以将Position成员合并(因为也是字符串类型),或者是交换Name和Address出现的先后顺序,那样的话就是定义了不同的结构体类型。通常,我们只是将相关的成员写到一起。
如果结构体成员名字是以大写字母开头的,那么该成员就是导出的;这是Go语言导出规则决定的。一个结构体可能同时包含导出和未导出的成员。
结构体类型往往是冗长的,因为它的每个成员可能都会占一行。虽然我们每次都可以重写整个结构体成员,但是重复会令人厌烦。因此,完整的结构体写法通常只在类型声明语句的地方出现,就像Employee类型声明语句那样。
一个命名为S的结构体类型将不能再包含S类型的成员:因为一个聚合的值不能包含它自身。(该限制同样适用于数组。)但是S类型的结构体可以包含*S指针类型的成员,这可以让我们创建递归的数据结构,比如链表和树结构等。在下面的代码中,我们使用一个二叉树来实现一个插入排序:
type tree struct {
	value       int
	left, right *tree
}

// Sort sorts values in place.
func Sort(values []int) {
	var root *tree
	for _, v := range values {
		root = add(root, v)
	}
	appendValues(values[:0], root)
}

// appendValues appends the elements of t to values in order
// and returns the resulting slice.
func appendValues(values []int, t *tree) []int {
	if t != nil {
		values = appendValues(values, t.left)
		values = append(values, t.value)
		values = appendValues(values, t.right)
	}
	return values
}

func add(t *tree, value int) *tree {
	if t == nil {
		// Equivalent to return &tree{value: value}.
		t = new(tree)
		t.value = value
		return t
	}
	if value < t.value {
		t.left = add(t.left, value)
	} else {
		t.right = add(t.right, value)
	}
	return t
}
结构体类型的零值是每个成员都是零值。通常会将零值作为最合理的默认值。例如,对于bytes.Buffer类型,结构体初始值就是一个随时可用的空缓存,还有在第9章将会讲到的sync.Mutex的零值也是有效的未锁定状态。有时候这种零值可用的特性是自然获得的,但是也有些类型需要一些额外的工作。
如果结构体没有任何成员的话就是空结构体,写作struct{}。它的大小为0,也不包含任何信息,但是有时候依然是有价值的。有些Go语言程序员用map来模拟set数据结构时,用它来代替map中布尔类型的value,只是强调key的重要性,但是因为节约的空间有限,而且语法比较复杂,所以我们通常会避免这样的用法。
seen := make(map[string]struct{}) // set of strings
// ...
if _, ok := seen[s]; !ok {
	seen[s] = struct{}{}
	// ...first time seeing s...
}
4.4.1. 结构体字面值
结构体值也可以用结构体字面值表示,结构体字面值可以指定每个成员的值。
type Point struct{ X, Y int }

p := Point{1, 2}
这里有两种形式的结构体字面值语法,上面的是第一种写法,要求以结构体成员定义的顺序为每个结构体成员指定一个字面值。它要求写代码和读代码的人要记住结构体的每个成员的类型和顺序,不过结构体成员有细微的调整就可能导致上述代码不能编译。因此,上述的语法一般只在定义结构体的包内部使用,或者是在较小的结构体中使用,这些结构体的成员排列比较规则,比如image.Point{x, y}或color.RGBA{red, green, blue, alpha}。
其实更常用的是第二种写法,以成员名字和相应的值来初始化,可以包含部分或全部的成员,如1.4节的Lissajous程序的写法:
anim := gif.GIF{LoopCount: nframes}在这种形式的结构体字面值写法中,如果成员被忽略的话将默认用零值。因为提供了成员的名字,所以成员出现的顺序并不重要。
两种不同形式的写法不能混合使用。而且,你不能企图在外部包中用第一种顺序赋值的技巧来偷偷地初始化结构体中未导出的成员。
package p
type T struct{ a, b int } // a and b are not exported

package q
import "p"
var _ = p.T{a: 1, b: 2} // compile error: can't reference a, b
var _ = p.T{1, 2}       // compile error: can't reference a, b
虽然上面最后一行代码的编译错误信息中并没有显式提到未导出的成员,但是这样企图隐式使用未导出成员的行为也是不允许的。
结构体可以作为函数的参数和返回值。例如,这个Scale函数将Point类型的值缩放后返回:
func Scale(p Point, factor int) Point {
	return Point{p.X * factor, p.Y * factor}
}

fmt.Println(Scale(Point{1, 2}, 5)) // "{5 10}"
如果考虑效率的话,较大的结构体通常会用指针的方式传入和返回,
func Bonus(e *Employee, percent int) int {
	return e.Salary * percent / 100
}
如果要在函数内部修改结构体成员的话,用指针传入是必须的;因为在Go语言中,所有的函数参数都是值拷贝传入的,函数参数将不再是函数调用时的原始变量。
func AwardAnnualRaise(e *Employee) {
	e.Salary = e.Salary * 105 / 100
}
因为结构体通常通过指针处理,可以用下面的写法来创建并初始化一个结构体变量,并返回结构体的地址:
pp := &Point{1, 2}它和下面的语句是等价的
pp := new(Point)
*pp = Point{1, 2}
不过&Point{1, 2}写法可以直接在表达式中使用,比如一个函数调用。
4.4.2. 结构体比较
如果结构体的全部成员都是可以比较的,那么结构体也是可以比较的,那样的话两个结构体将可以使用或!=运算符进行比较。相等比较运算符将比较两个结构体的每个成员,因此下面两个比较的表达式是等价的:
type Point struct{ X, Y int }

p := Point{1, 2}
q := Point{2, 1}
fmt.Println(p.X == q.X && p.Y == q.Y) // "false"
fmt.Println(p == q)                   // "false"
可比较的结构体类型和其他可比较的类型一样,可以用于map的key类型。
type address struct {
	hostname string
	port     int
}

hits := make(map[address]int)
hits[address{"golang.org", 443}]++
4.4.3. 结构体嵌入和匿名成员
在本节中,我们将看到如何使用Go语言提供的不同寻常的结构体嵌入机制让一个命名的结构体包含另一个结构体类型的匿名成员,这样就可以通过简单的点运算符x.f来访问匿名成员链中嵌套的x.d.e.f成员。
考虑一个二维的绘图程序,提供了一个各种图形的库,例如矩形、椭圆形、星形和轮形等几何形状。这里是其中两个的定义:
type Circle struct {
	X, Y, Radius int
}

type Wheel struct {
	X, Y, Radius, Spokes int
}
一个Circle代表的圆形类型包含了标准圆心的X和Y坐标信息,和一个Radius表示的半径信息。一个Wheel轮形除了包含Circle类型所有的全部成员外,还增加了Spokes表示径向辐条的数量。我们可以这样创建一个wheel变量:
var w Wheel
w.X = 8
w.Y = 8
w.Radius = 5
w.Spokes = 20
随着库中几何形状数量的增多,我们一定会注意到它们之间的相似和重复之处,所以我们可能为了便于维护而将相同的属性独立出来:
type Point struct {
	X, Y int
}

type Circle struct {
	Center Point
	Radius int
}

type Wheel struct {
	Circle Circle
	Spokes int
}
这样改动之后结构体类型变的清晰了,但是这种修改同时也导致了访问每个成员变得繁琐:
var w Wheel
w.Circle.Center.X = 8
w.Circle.Center.Y = 8
w.Circle.Radius = 5
w.Spokes = 20
Go语言有一个特性让我们只声明一个成员对应的数据类型而不指名成员的名字;这类成员就叫匿名成员。匿名成员的数据类型必须是命名的类型或指向一个命名的类型的指针。下面的代码中,Circle和Wheel各自都有一个匿名成员。我们可以说Point类型被嵌入到了Circle结构体,同时Circle类型被嵌入到了Wheel结构体。
type Circle struct {
	Point
	Radius int
}

type Wheel struct {
	Circle
	Spokes int
}
得益于匿名嵌入的特性,我们可以直接访问叶子属性而不需要给出完整的路径:
var w Wheel
w.X = 8            // equivalent to w.Circle.Point.X = 8
w.Y = 8            // equivalent to w.Circle.Point.Y = 8
w.Radius = 5       // equivalent to w.Circle.Radius = 5
w.Spokes = 20
在右边的注释中给出的显式形式访问这些叶子成员的语法依然有效,因此匿名成员并不是真的无法访问了。其中匿名成员Circle和Point都有自己的名字——就是命名的类型名字——但是这些名字在点操作符中是可选的。我们在访问子成员的时候可以忽略任何匿名成员部分。
不幸的是,结构体字面值并没有简短表示匿名成员的语法, 因此下面的语句都不能编译通过:
w = Wheel{8, 8, 5, 20}                       // compile error: unknown fields
w = Wheel{X: 8, Y: 8, Radius: 5, Spokes: 20} // compile error: unknown fields
结构体字面值必须遵循形状类型声明时的结构,所以我们只能用下面的两种语法,它们彼此是等价的:
w = Wheel{Circle{Point{8, 8}, 5}, 20}

w = Wheel{
	Circle: Circle{
		Point:  Point{X: 8, Y: 8},
		Radius: 5,
	},
	Spokes: 20, // NOTE: trailing comma necessary here (and at Radius)
}

fmt.Printf("%#v\n", w)
// Output:
// Wheel{Circle:Circle{Point:Point{X:8, Y:8}, Radius:5}, Spokes:20}

w.X = 42

fmt.Printf("%#v\n", w)
// Output:
// Wheel{Circle:Circle{Point:Point{X:42, Y:8}, Radius:5}, Spokes:20}
需要注意的是Printf函数中%v参数包含的#副词,它表示用和Go语言类似的语法打印值。对于结构体类型来说,将包含每个成员的名字。
因为匿名成员也有一个隐式的名字,因此不能同时包含两个类型相同的匿名成员,这会导致名字冲突。同时,因为成员的名字是由其类型隐式地决定的,所以匿名成员也有可见性的规则约束。在上面的例子中,Point和Circle匿名成员都是导出的。即使它们不导出(比如改成小写字母开头的point和circle),我们依然可以用简短形式访问匿名成员嵌套的成员
w.X = 8 // equivalent to w.circle.point.X = 8但是在包外部,因为circle和point没有导出,不能访问它们的成员,因此简短的匿名成员访问语法也是禁止的。
到目前为止,我们看到匿名成员特性只是对访问嵌套成员的点运算符提供了简短的语法糖。稍后,我们将会看到匿名成员并不要求是结构体类型;其实任何命名的类型都可以作为结构体的匿名成员。但是为什么要嵌入一个没有任何子成员类型的匿名成员类型呢?
答案是匿名类型的方法集。简短的点运算符语法可以用于选择匿名成员嵌套的成员,也可以用于访问它们的方法。实际上,外层的结构体不仅仅是获得了匿名成员类型的所有成员,而且也获得了该类型导出的全部的方法。这个机制可以用于将一些有简单行为的对象组合成有复杂行为的对象。组合是Go语言中面向对象编程的核心,我们将在6.3节中专门讨论。
4.5. JSON
JavaScript对象表示法(JSON)是一种用于发送和接收结构化信息的标准协议。在类似的协议中,JSON并不是唯一的一个标准协议。 XML(§7.14)、ASN.1和Google的Protocol Buffers都是类似的协议,并且有各自的特色,但是由于简洁性、可读性和流行程度等原因,JSON是应用最广泛的一个。
Go语言对于这些标准格式的编码和解码都有良好的支持,由标准库中的encoding/json、encoding/xml、encoding/asn1等包提供支持(译注:Protocol Buffers的支持由 github.com/golang/protobuf 包提供),并且这类包都有着相似的API接口。本节,我们将对重要的encoding/json包的用法做个概述。
JSON是对JavaScript中各种类型的值——字符串、数字、布尔值和对象——Unicode本文编码。它可以用有效可读的方式表示第三章的基础数据类型和本章的数组、slice、结构体和map等聚合数据类型。
基本的JSON类型有数字(十进制或科学记数法)、布尔值(true或false)、字符串,其中字符串是以双引号包含的Unicode字符序列,支持和Go语言类似的反斜杠转义特性,不过JSON使用的是\Uhhhh转义数字来表示一个UTF-16编码(译注:UTF-16和UTF-8一样是一种变长的编码,有些Unicode码点较大的字符需要用4个字节表示;而且UTF-16还有大端和小端的问题),而不是Go语言的rune类型。
这些基础类型可以通过JSON的数组和对象类型进行递归组合。一个JSON数组是一个有序的值序列,写在一个方括号中并以逗号分隔;一个JSON数组可以用于编码Go语言的数组和slice。一个JSON对象是一个字符串到值的映射,写成一系列的name:value对形式,用花括号包含并以逗号分隔;JSON的对象类型可以用于编码Go语言的map类型(key类型是字符串)和结构体。例如:
boolean         true
number          -273.15
string          "She said \"Hello, BF\""
array           ["gold", "silver", "bronze"]
object          {"year": 1980,
                 "event": "archery",
                 "medals": ["gold", "silver", "bronze"]}
考虑一个应用程序,该程序负责收集各种电影评论并提供反馈功能。它的Movie数据类型和一个典型的表示电影的值列表如下所示。(在结构体声明中,Year和Color成员后面的字符串面值是结构体成员Tag;我们稍后会解释它的作用。)
type Movie struct {
	Title  string
	Year   int  `json:"released"`
	Color  bool `json:"color,omitempty"`
	Actors []string
}

var movies = []Movie{
	{Title: "Casablanca", Year: 1942, Color: false,
		Actors: []string{"Humphrey Bogart", "Ingrid Bergman"}},
	{Title: "Cool Hand Luke", Year: 1967, Color: true,
		Actors: []string{"Paul Newman"}},
	{Title: "Bullitt", Year: 1968, Color: true,
		Actors: []string{"Steve McQueen", "Jacqueline Bisset"}},
	// ...
}
这样的数据结构特别适合JSON格式,并且在两者之间相互转换也很容易。将一个Go语言中类似movies的结构体slice转为JSON的过程叫编组(marshaling)。编组通过调用json.Marshal函数完成:
data, err := json.Marshal(movies)
if err != nil {
	log.Fatalf("JSON marshaling failed: %s", err)
}
fmt.Printf("%s\n", data)
Marshal函数返回一个编码后的字节slice,包含很长的字符串,并且没有空白缩进;我们将它折行以便于显示:
[{"Title":"Casablanca","released":1942,"Actors":["Humphrey Bogart","Ingr
id Bergman"]},{"Title":"Cool Hand Luke","released":1967,"color":true,"Ac
tors":["Paul Newman"]},{"Title":"Bullitt","released":1968,"color":true,"
Actors":["Steve McQueen","Jacqueline Bisset"]}]
这种紧凑的表示形式虽然包含了全部的信息,但是很难阅读。为了生成便于阅读的格式,另一个json.MarshalIndent函数将产生整齐缩进的输出。该函数有两个额外的字符串参数用于表示每一行输出的前缀和每一个层级的缩进:
data, err := json.MarshalIndent(movies, "", "    ")
if err != nil {
	log.Fatalf("JSON marshaling failed: %s", err)
}
fmt.Printf("%s\n", data)
上面的代码将产生这样的输出(译注:在最后一个成员或元素后面并没有逗号分隔符):
[
	{
		"Title": "Casablanca",
		"released": 1942,
		"Actors": [
			"Humphrey Bogart",
			"Ingrid Bergman"
		]
	},
	{
		"Title": "Cool Hand Luke",
		"released": 1967,
		"color": true,
		"Actors": [
			"Paul Newman"
		]
	},
	{
		"Title": "Bullitt",
		"released": 1968,
		"color": true,
		"Actors": [
			"Steve McQueen",
			"Jacqueline Bisset"
		]
	}
]
在编码时,默认使用Go语言结构体的成员名字作为JSON的对象(通过reflect反射技术,我们将在12.6节讨论)。只有导出的结构体成员才会被编码,这也就是我们为什么选择用大写字母开头的成员名称。
细心的读者可能已经注意到,其中Year名字的成员在编码后变成了released,还有Color成员编码后变成了小写字母开头的color。这是因为结构体成员Tag所导致的。一个结构体成员Tag是和在编译阶段关联到该成员的元信息字符串:
Year  int  `json:"released"`
Color bool `json:"color,omitempty"`
结构体的成员Tag可以是任意的字符串面值,但是通常是一系列用空格分隔的key:"value"键值对序列;因为值中含有双引号字符,因此成员Tag一般用原生字符串面值的形式书写。json开头键名对应的值用于控制encoding/json包的编码和解码的行为,并且encoding/...下面其它的包也遵循这个约定。成员Tag中json对应值的第一部分用于指定JSON对象的名字,比如将Go语言中的TotalCount成员对应到JSON中的total_count对象。Color成员的Tag还带了一个额外的omitempty选项,表示当Go语言结构体成员为空或零值时不生成该JSON对象(这里false为零值)。果然,Casablanca是一个黑白电影,并没有输出Color成员。
编码的逆操作是解码,对应将JSON数据解码为Go语言的数据结构,Go语言中一般叫unmarshaling,通过json.Unmarshal函数完成。下面的代码将JSON格式的电影数据解码为一个结构体slice,结构体中只有Title成员。通过定义合适的Go语言数据结构,我们可以选择性地解码JSON中感兴趣的成员。当Unmarshal函数调用返回,slice将被只含有Title信息的值填充,其它JSON成员将被忽略。
var titles []struct{ Title string }
if err := json.Unmarshal(data, &titles); err != nil {
	log.Fatalf("JSON unmarshaling failed: %s", err)
}
fmt.Println(titles) // "[{Casablanca} {Cool Hand Luke} {Bullitt}]"
许多web服务都提供JSON接口,通过HTTP接口发送JSON格式请求并返回JSON格式的信息。为了说明这一点,我们通过Github的issue查询服务来演示类似的用法。首先,我们要定义合适的类型和常量:
// Package github provides a Go API for the GitHub issue tracker.
// See https://developer.github.com/v3/search/#search-issues.
package github
import "time"
const IssuesURL = "https://api.github.com/search/issues"
type IssuesSearchResult struct {
TotalCount int `json:"total_count"`
Items []*Issue
}
type Issue struct {
Number int
HTMLURL string `json:"html_url"`
Title string
State string
User *User
CreatedAt time.Time `json:"created_at"`
Body string // in Markdown format
}
type User struct {
Login string
HTMLURL string `json:"html_url"`
}和前面一样,即使对应的JSON对象名是小写字母,每个结构体的成员名也是声明为大写字母开头的。因为有些JSON成员名字和Go结构体成员名字并不相同,因此需要Go语言结构体成员Tag来指定对应的JSON名字。同样,在解码的时候也需要做同样的处理,GitHub服务返回的信息比我们定义的要多很多。
SearchIssues函数发出一个HTTP请求,然后解码返回的JSON格式的结果。因为用户提供的查询条件可能包含类似?和&之类的特殊字符,为了避免对URL造成冲突,我们用url.QueryEscape来对查询中的特殊字符进行转义操作。
package github
import (
"encoding/json"
"fmt"
"net/http"
"net/url"
"strings"
)
// SearchIssues queries the GitHub issue tracker.
func SearchIssues(terms []string) (*IssuesSearchResult, error) {
q := url.QueryEscape(strings.Join(terms, " "))
resp, err := http.Get(IssuesURL + "?q=" + q)
if err != nil {
return nil, err
}
// We must close resp.Body on all execution paths.
// (Chapter 5 presents 'defer', which makes this simpler.)
if resp.StatusCode != http.StatusOK {
resp.Body.Close()
return nil, fmt.Errorf("search query failed: %s", resp.Status)
}
var result IssuesSearchResult
if err := json.NewDecoder(resp.Body).Decode(&result); err != nil {
resp.Body.Close()
return nil, err
}
resp.Body.Close()
return &result, nil
}在早些的例子中,我们使用了json.Unmarshal函数来将JSON格式的字符串解码为字节slice。但是这个例子中,我们使用了基于流式的解码器json.Decoder,它可以从一个输入流解码JSON数据,尽管这不是必须的。如您所料,还有一个针对输出流的json.Encoder编码对象。
我们调用Decode方法来填充变量。这里有多种方法可以格式化结构。下面是最简单的一种,以一个固定宽度打印每个issue,但是在下一节我们将看到如何利用模板来输出复杂的格式。
// Issues prints a table of GitHub issues matching the search terms.
package main
import (
"fmt"
"log"
"os"
"gopl.io/ch4/github"
)
func main() {
result, err := github.SearchIssues(os.Args[1:])
if err != nil {
log.Fatal(err)
}
fmt.Printf("%d issues:\n", result.TotalCount)
for _, item := range result.Items {
fmt.Printf("#%-5d %9.9s %.55s\n",
item.Number, item.User.Login, item.Title)
}
}通过命令行参数指定检索条件。下面的命令是查询Go语言项目中和JSON解码相关的问题,还有查询返回的结果:
$ go build gopl.io/ch4/issues
$ ./issues repo:golang/go is:open json decoder
13 issues:
#5680 eaigner encoding/json: set key converter on en/decoder
#6050 gopherbot encoding/json: provide tokenizer
#8658 gopherbot encoding/json: use bufio
#8462 kortschak encoding/json: UnmarshalText confuses json.Unmarshal
#5901 rsc encoding/json: allow override type marshaling
#9812 klauspost encoding/json: string tag not symmetric
#7872 extempora encoding/json: Encoder internally buffers full output
#9650 cespare encoding/json: Decoding gives errPhase when unmarshalin
#6716 gopherbot encoding/json: include field name in unmarshal error me
#6901 lukescott encoding/json, encoding/xml: option to treat unknown fi
#6384 joeshaw encoding/json: encode precise floating point integers u
#6647 btracey x/tools/cmd/godoc: display type kind of each named type
#4237 gjemiller encoding/base64: URLEncoding padding is optionalGitHub的Web服务接口 https://developer.github.com/v3/ 包含了更多的特性。
4.6. 文本和HTML模板
前面的例子,只是最简单的格式化,使用Printf是完全足够的。但是有时候会需要复杂的打印格式,这时候一般需要将格式化代码分离出来以便更安全地修改。这些功能是由text/template和html/template等模板包提供的,它们提供了一个将变量值填充到一个文本或HTML格式的模板的机制。
一个模板是一个字符串或一个文件,里面包含了一个或多个由双花括号包含的{{action}}对象。大部分的字符串只是按字面值打印,但是对于actions部分将触发其它的行为。每个actions都包含了一个用模板语言书写的表达式,一个action虽然简短但是可以输出复杂的打印值,模板语言包含通过选择结构体的成员、调用函数或方法、表达式控制流if-else语句和range循环语句,还有其它实例化模板等诸多特性。下面是一个简单的模板字符串:
const templ = `{{.TotalCount}} issues:
{{range .Items}}----------------------------------------
Number: {{.Number}}
User: {{.User.Login}}
Title: {{.Title | printf "%.64s"}}
Age: {{.CreatedAt | daysAgo}} days
{{end}}`这个模板先打印匹配到的issue总数,然后打印每个issue的编号、创建用户、标题还有存在的时间。对于每一个action,都有一个当前值的概念,对应点操作符,写作“.”。当前值“.”最初被初始化为调用模板时的参数,在当前例子中对应github.IssuesSearchResult类型的变量。模板中{{.TotalCount}}对应action将展开为结构体中TotalCount成员以默认的方式打印的值。模板中{{range .Items}}和{{end}}对应一个循环action,因此它们之间的内容可能会被展开多次,循环每次迭代的当前值对应当前的Items元素的值。
在一个action中,|操作符表示将前一个表达式的结果作为后一个函数的输入,类似于UNIX中管道的概念。在Title这一行的action中,第二个操作是一个printf函数,是一个基于fmt.Sprintf实现的内置函数,所有模板都可以直接使用。对于Age部分,第二个动作是一个叫daysAgo的函数,通过time.Since函数将CreatedAt成员转换为过去的时间长度:
func daysAgo(t time.Time) int {
return int(time.Since(t).Hours() / 24)
}需要注意的是CreatedAt的参数类型是time.Time,并不是字符串。以同样的方式,我们可以通过定义一些方法来控制字符串的格式化(§2.5),一个类型同样可以定制自己的JSON编码和解码行为。time.Time类型对应的JSON值是一个标准时间格式的字符串。
生成模板的输出需要两个处理步骤。第一步是要分析模板并转为内部表示,然后基于指定的输入执行模板。分析模板部分一般只需要执行一次。下面的代码创建并分析上面定义的模板templ。注意方法调用链的顺序:template.New先创建并返回一个模板;Funcs方法将daysAgo等自定义函数注册到模板中,并返回模板;最后调用Parse函数分析模板。
report, err := template.New("report").
Funcs(template.FuncMap{"daysAgo": daysAgo}).
Parse(templ)
if err != nil {
log.Fatal(err)
}因为模板通常在编译时就测试好了,如果模板解析失败将是一个致命的错误。template.Must辅助函数可以简化这个致命错误的处理:它接受一个模板和一个error类型的参数,检测error是否为nil(如果不是nil则发出panic异常),然后返回传入的模板。我们将在5.9节再讨论这个话题。
一旦模板已经创建、注册了daysAgo函数、并通过分析和检测,我们就可以使用github.IssuesSearchResult作为输入源、os.Stdout作为输出源来执行模板:
var report = template.Must(template.New("issuelist").
Funcs(template.FuncMap{"daysAgo": daysAgo}).
Parse(templ))
func main() {
result, err := github.SearchIssues(os.Args[1:])
if err != nil {
log.Fatal(err)
}
if err := report.Execute(os.Stdout, result); err != nil {
log.Fatal(err)
}
}程序输出一个纯文本报告:
$ go build gopl.io/ch4/issuesreport
$ ./issuesreport repo:golang/go is:open json decoder
13 issues:
----------------------------------------
Number: 5680
User: eaigner
Title: encoding/json: set key converter on en/decoder
Age: 750 days
----------------------------------------
Number: 6050
User: gopherbot
Title: encoding/json: provide tokenizer
Age: 695 days
----------------------------------------
...现在让我们转到html/template模板包。它使用和text/template包相同的API和模板语言,但是增加了一个将字符串自动转义特性,这可以避免输入字符串和HTML、JavaScript、CSS或URL语法产生冲突的问题。这个特性还可以避免一些长期存在的安全问题,比如通过生成HTML注入攻击,通过构造一个含有恶意代码的问题标题,这些都可能让模板输出错误的输出,从而让他们控制页面。
下面的模板以HTML格式输出issue列表。注意import语句的不同:
import "html/template"
var issueList = template.Must(template.New("issuelist").Parse(`
<h1>{{.TotalCount}} issues</h1>
<table>
<tr style='text-align: left'>
<th>#</th>
<th>State</th>
<th>User</th>
<th>Title</th>
</tr>
{{range .Items}}
<tr>
<td><a href='{{.HTMLURL}}'>{{.Number}}</a></td>
<td>{{.State}}</td>
<td><a href='{{.User.HTMLURL}}'>{{.User.Login}}</a></td>
<td><a href='{{.HTMLURL}}'>{{.Title}}</a></td>
</tr>
{{end}}
</table>
`))下面的命令将在新的模板上执行一个稍微不同的查询:
$ go build gopl.io/ch4/issueshtml
$ ./issueshtml repo:golang/go commenter:gopherbot json encoder >issues.html图4.4显示了在web浏览器中的效果图。每个issue包含到Github对应页面的链接。
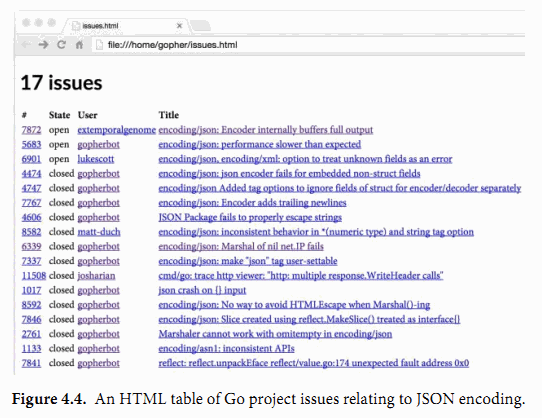
图4.4中issue没有包含会对HTML格式产生冲突的特殊字符,但是我们马上将看到标题中含有&和<字符的issue。下面的命令选择了两个这样的issue:
$ ./issueshtml repo:golang/go 3133 10535 >issues2.html图4.5显示了该查询的结果。注意,html/template包已经自动将特殊字符转义,因此我们依然可以看到正确的字面值。如果我们使用text/template包的话,这2个issue将会产生错误,其中“<”四个字符将会被当作小于字符“<”处理,同时“<link>”字符串将会被当作一个链接元素处理,它们都会导致HTML文档结构的改变,从而导致有未知的风险。
我们也可以通过对信任的HTML字符串使用template.HTML类型来抑制这种自动转义的行为。还有很多采用类型命名的字符串类型分别对应信任的JavaScript、CSS和URL。下面的程序演示了两个使用不同类型的相同字符串产生的不同结果:A是一个普通字符串,B是一个信任的template.HTML字符串类型。
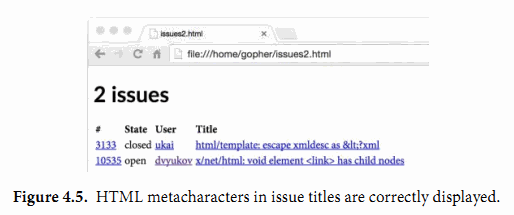
func main() {
const templ = `<p>A: {{.A}}</p><p>B: {{.B}}</p>`
t := template.Must(template.New("escape").Parse(templ))
var data struct {
A string // untrusted plain text
B template.HTML // trusted HTML
}
data.A = "<b>Hello!</b>"
data.B = "<b>Hello!</b>"
if err := t.Execute(os.Stdout, data); err != nil {
log.Fatal(err)
}
}图4.6显示了出现在浏览器中的模板输出。我们看到A的黑体标记被转义失效了,但是B没有。
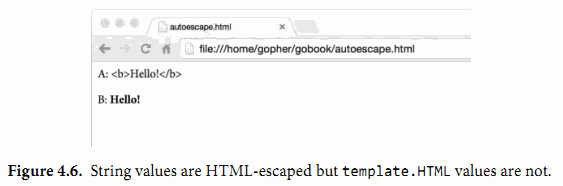
我们这里只讲述了模板系统中最基本的特性。一如既往,如果想了解更多的信息,请自己查看包文档:
$ go doc text/template
$ go doc html/template5.1. 函数声明
函数声明包括函数名、形式参数列表、返回值列表(可省略)以及函数体。
func name(parameter-list) (result-list) {
body
}形式参数列表描述了函数的参数名以及参数类型。这些参数作为局部变量,其值由参数调用者提供。返回值列表描述了函数返回值的变量名以及类型。如果函数返回一个无名变量或者没有返回值,返回值列表的括号是可以省略的。如果一个函数声明不包括返回值列表,那么函数体执行完毕后,不会返回任何值。在hypot函数中:
func hypot(x, y float64) float64 {
return math.Sqrt(x*x + y*y)
}
fmt.Println(hypot(3,4)) // "5"x和y是形参名,3和4是调用时的传入的实参,函数返回了一个float64类型的值。
返回值也可以像形式参数一样被命名。在这种情况下,每个返回值被声明成一个局部变量,并根据该返回值的类型,将其初始化为该类型的零值。
如果一个函数在声明时,包含返回值列表,该函数必须以 return语句结尾,除非函数明显无法运行到结尾处。例如函数在结尾时调用了panic异常或函数中存在无限循环。
正如hypot一样,如果一组形参或返回值有相同的类型,我们不必为每个形参都写出参数类型。下面2个声明是等价的:
func f(i, j, k int, s, t string) { /* ... */ }
func f(i int, j int, k int, s string, t string) { /* ... */ }下面,我们给出4种方法声明拥有2个int型参数和1个int型返回值的函数.blank identifier(译者注:即下文的_符号)可以强调某个参数未被使用。
func add(x int, y int) int {return x + y}
func sub(x, y int) (z int) { z = x - y; return}
func first(x int, _ int) int { return x }
func zero(int, int) int { return 0 }
fmt.Printf("%T\n", add) // "func(int, int) int"
fmt.Printf("%T\n", sub) // "func(int, int) int"
fmt.Printf("%T\n", first) // "func(int, int) int"
fmt.Printf("%T\n", zero) // "func(int, int) int"函数的类型被称为函数的签名。如果两个函数形式参数列表和返回值列表中的变量类型一一对应,那么这两个函数被认为有相同的类型或签名。形参和返回值的变量名不影响函数签名,也不影响它们是否可以以省略参数类型的形式表示。
每一次函数调用都必须按照声明顺序为所有参数提供实参(参数值)。在函数调用时,Go语言没有默认参数值,也没有任何方法可以通过参数名指定形参,因此形参和返回值的变量名对于函数调用者而言没有意义。
在函数体中,函数的形参作为局部变量,被初始化为调用者提供的值。函数的形参和有名返回值作为函数最外层的局部变量,被存储在相同的词法块中。
实参通过值的方式传递,因此函数的形参是实参的拷贝。对形参进行修改不会影响实参。但是,如果实参包括引用类型,如指针,slice(切片)、map、function、channel等类型,实参可能会由于函数的间接引用被修改。
你可能会偶尔遇到没有函数体的函数声明,这表示该函数不是以Go实现的。这样的声明定义了函数签名。
package math
func Sin(x float64) float //implemented in assembly language5.2. 递归
函数可以是递归的,这意味着函数可以直接或间接的调用自身。对许多问题而言,递归是一种强有力的技术,例如处理递归的数据结构。在4.4节,我们通过遍历二叉树来实现简单的插入排序,在本章节,我们再次使用它来处理HTML文件。
下文的示例代码使用了非标准包 golang.org/x/net/html ,解析HTML。golang.org/x/... 目录下存储了一些由Go团队设计、维护,对网络编程、国际化文件处理、移动平台、图像处理、加密解密、开发者工具提供支持的扩展包。未将这些扩展包加入到标准库原因有二,一是部分包仍在开发中,二是对大多数Go语言的开发者而言,扩展包提供的功能很少被使用。
例子中调用golang.org/x/net/html的部分api如下所示。html.Parse函数读入一组bytes解析后,返回html.Node类型的HTML页面树状结构根节点。HTML拥有很多类型的结点如text(文本)、comments(注释)类型,在下面的例子中,我们 只关注< name key='value' >形式的结点。
package html
type Node struct {
Type NodeType
Data string
Attr []Attribute
FirstChild, NextSibling *Node
}
type NodeType int32
const (
ErrorNode NodeType = iota
TextNode
DocumentNode
ElementNode
CommentNode
DoctypeNode
)
type Attribute struct {
Key, Val string
}
func Parse(r io.Reader) (*Node, error)main函数解析HTML标准输入,通过递归函数visit获得links(链接),并打印出这些links:
// Findlinks1 prints the links in an HTML document read from standard input.
package main
import (
"fmt"
"os"
"golang.org/x/net/html"
)
func main() {
doc, err := html.Parse(os.Stdin)
if err != nil {
fmt.Fprintf(os.Stderr, "findlinks1: %v\n", err)
os.Exit(1)
}
for _, link := range visit(nil, doc) {
fmt.Println(link)
}
}visit函数遍历HTML的节点树,从每一个anchor元素的href属性获得link,将这些links存入字符串数组中,并返回这个字符串数组。
// visit appends to links each link found in n and returns the result.
func visit(links []string, n *html.Node) []string {
if n.Type == html.ElementNode && n.Data == "a" {
for _, a := range n.Attr {
if a.Key == "href" {
links = append(links, a.Val)
}
}
}
for c := n.FirstChild; c != nil; c = c.NextSibling {
links = visit(links, c)
}
return links
}为了遍历结点n的所有后代结点,每次遇到n的孩子结点时,visit递归的调用自身。这些孩子结点存放在FirstChild链表中。
让我们以Go的主页(golang.org)作为目标,运行findlinks。我们以fetch(1.5章)的输出作为findlinks的输入。下面的输出做了简化处理。
$ go build gopl.io/ch1/fetch
$ go build gopl.io/ch5/findlinks1
$ ./fetch https://golang.org | ./findlinks1
#
/doc/
/pkg/
/help/
/blog/
http://play.golang.org/
//tour.golang.org/
https://golang.org/dl/
//blog.golang.org/
/LICENSE
/doc/tos.html
http://www.google.com/intl/en/policies/privacy/注意在页面中出现的链接格式,在之后我们会介绍如何将这些链接,根据根路径( https://golang.org )生成可以直接访问的url。
在函数outline中,我们通过递归的方式遍历整个HTML结点树,并输出树的结构。在outline内部,每遇到一个HTML元素标签,就将其入栈,并输出。
func main() {
doc, err := html.Parse(os.Stdin)
if err != nil {
fmt.Fprintf(os.Stderr, "outline: %v\n", err)
os.Exit(1)
}
outline(nil, doc)
}
func outline(stack []string, n *html.Node) {
if n.Type == html.ElementNode {
stack = append(stack, n.Data) // push tag
fmt.Println(stack)
}
for c := n.FirstChild; c != nil; c = c.NextSibling {
outline(stack, c)
}
}有一点值得注意:outline有入栈操作,但没有相对应的出栈操作。当outline调用自身时,被调用者接收的是stack的拷贝。被调用者对stack的元素追加操作,修改的是stack的拷贝,其可能会修改slice底层的数组甚至是申请一块新的内存空间进行扩容;但这个过程并不会修改调用方的stack。因此当函数返回时,调用方的stack与其调用自身之前完全一致。
下面是 https://golang.org 页面的简要结构:
$ go build gopl.io/ch5/outline
$ ./fetch https://golang.org | ./outline
[html]
[html head]
[html head meta]
[html head title]
[html head link]
[html body]
[html body div]
[html body div]
[html body div div]
[html body div div form]
[html body div div form div]
[html body div div form div a]
...正如你在上面实验中所见,大部分HTML页面只需几层递归就能被处理,但仍然有些页面需要深层次的递归。
大部分编程语言使用固定大小的函数调用栈,常见的大小从64KB到2MB不等。固定大小栈会限制递归的深度,当你用递归处理大量数据时,需要避免栈溢出;除此之外,还会导致安全性问题。与此相反,Go语言使用可变栈,栈的大小按需增加(初始时很小)。这使得我们使用递归时不必考虑溢出和安全问题。
5.3. 多返回值
在Go中,一个函数可以返回多个值。我们已经在之前例子中看到,许多标准库中的函数返回2个值,一个是期望得到的返回值,另一个是函数出错时的错误信息。下面的例子会展示如何编写多返回值的函数。
下面的程序是findlinks的改进版本。修改后的findlinks可以自己发起HTTP请求,这样我们就不必再运行fetch。因为HTTP请求和解析操作可能会失败,因此findlinks声明了2个返回值:链接列表和错误信息。一般而言,HTML的解析器可以处理HTML页面的错误结点,构造出HTML页面结构,所以解析HTML很少失败。这意味着如果findlinks函数失败了,很可能是由于I/O的错误导致的。
func main() {
for _, url := range os.Args[1:] {
links, err := findLinks(url)
if err != nil {
fmt.Fprintf(os.Stderr, "findlinks2: %v\n", err)
continue
}
for _, link := range links {
fmt.Println(link)
}
}
}
// findLinks performs an HTTP GET request for url, parses the
// response as HTML, and extracts and returns the links.
func findLinks(url string) ([]string, error) {
resp, err := http.Get(url)
if err != nil {
return nil, err
}
if resp.StatusCode != http.StatusOK {
resp.Body.Close()
return nil, fmt.Errorf("getting %s: %s", url, resp.Status)
}
doc, err := html.Parse(resp.Body)
resp.Body.Close()
if err != nil {
return nil, fmt.Errorf("parsing %s as HTML: %v", url, err)
}
return visit(nil, doc), nil
}在findlinks中,有4处return语句,每一处return都返回了一组值。前三处return,将http和html包中的错误信息传递给findlinks的调用者。第一处return直接返回错误信息,其他两处通过fmt.Errorf(§7.8)输出详细的错误信息。如果findlinks成功结束,最后的return语句将一组解析获得的连接返回给用户。
在findlinks中,我们必须确保resp.Body被关闭,释放网络资源。虽然Go的垃圾回收机制会回收不被使用的内存,但是这不包括操作系统层面的资源,比如打开的文件、网络连接。因此我们必须显式的释放这些资源。
调用多返回值函数时,返回给调用者的是一组值,调用者必须显式的将这些值分配给变量:
links, err := findLinks(url)如果某个值不被使用,可以将其分配给blank identifier:
links, _ := findLinks(url) // errors ignored一个函数内部可以将另一个有多返回值的函数调用作为返回值,下面的例子展示了与findLinks有相同功能的函数,两者的区别在于下面的例子先输出参数:
func findLinksLog(url string) ([]string, error) {
log.Printf("findLinks %s", url)
return findLinks(url)
}当你调用接受多参数的函数时,可以将一个返回多参数的函数调用作为该函数的参数。虽然这很少出现在实际生产代码中,但这个特性在debug时很方便,我们只需要一条语句就可以输出所有的返回值。下面的代码是等价的:
log.Println(findLinks(url))
links, err := findLinks(url)
log.Println(links, err)准确的变量名可以传达函数返回值的含义。尤其在返回值的类型都相同时,就像下面这样:
func Size(rect image.Rectangle) (width, height int)
func Split(path string) (dir, file string)
func HourMinSec(t time.Time) (hour, minute, second int)虽然良好的命名很重要,但你也不必为每一个返回值都取一个适当的名字。比如,按照惯例,函数的最后一个bool类型的返回值表示函数是否运行成功,error类型的返回值代表函数的错误信息,对于这些类似的惯例,我们不必思考合适的命名,它们都无需解释。
如果一个函数所有的返回值都有显式的变量名,那么该函数的return语句可以省略操作数。这称之为bare return。
// CountWordsAndImages does an HTTP GET request for the HTML
// document url and returns the number of words and images in it.
func CountWordsAndImages(url string) (words, images int, err error) {
resp, err := http.Get(url)
if err != nil {
return
}
doc, err := html.Parse(resp.Body)
resp.Body.Close()
if err != nil {
err = fmt.Errorf("parsing HTML: %s", err)
return
}
words, images = countWordsAndImages(doc)
return
}
func countWordsAndImages(n *html.Node) (words, images int) { /* ... */ }按照返回值列表的次序,返回所有的返回值,在上面的例子中,每一个return语句等价于:
return words, images, err当一个函数有多处return语句以及许多返回值时,bare return 可以减少代码的重复,但是使得代码难以被理解。举个例子,如果你没有仔细的审查代码,很难发现前2处return等价于 return 0,0,err(Go会将返回值 words和images在函数体的开始处,根据它们的类型,将其初始化为0),最后一处return等价于 return words, image, nil。基于以上原因,不宜过度使用bare return。
5.4. 错误
在Go中有一部分函数总是能成功的运行。比如strings.Contains和strconv.FormatBool函数,对各种可能的输入都做了良好的处理,使得运行时几乎不会失败,除非遇到灾难性的、不可预料的情况,比如运行时的内存溢出。导致这种错误的原因很复杂,难以处理,从错误中恢复的可能性也很低。
还有一部分函数只要输入的参数满足一定条件,也能保证运行成功。比如time.Date函数,该函数将年月日等参数构造成time.Time对象,除非最后一个参数(时区)是nil。这种情况下会引发panic异常。panic是来自被调用函数的信号,表示发生了某个已知的bug。一个良好的程序永远不应该发生panic异常。
对于大部分函数而言,永远无法确保能否成功运行。这是因为错误的原因超出了程序员的控制。举个例子,任何进行I/O操作的函数都会面临出现错误的可能,只有没有经验的程序员才会相信读写操作不会失败,即使是简单的读写。因此,当本该可信的操作出乎意料的失败后,我们必须弄清楚导致失败的原因。
在Go的错误处理中,错误是软件包API和应用程序用户界面的一个重要组成部分,程序运行失败仅被认为是几个预期的结果之一。
对于那些将运行失败看作是预期结果的函数,它们会返回一个额外的返回值,通常是最后一个,来传递错误信息。如果导致失败的原因只有一个,额外的返回值可以是一个布尔值,通常被命名为ok。比如,cache.Lookup失败的唯一原因是key不存在,那么代码可以按照下面的方式组织:
value, ok := cache.Lookup(key)
if !ok {
// ...cache[key] does not exist…
}通常,导致失败的原因不止一种,尤其是对I/O操作而言,用户需要了解更多的错误信息。因此,额外的返回值不再是简单的布尔类型,而是error类型。
内置的error是接口类型。我们将在第七章了解接口类型的含义,以及它对错误处理的影响。现在我们只需要明白error类型可能是nil或者non-nil。nil意味着函数运行成功,non-nil表示失败。对于non-nil的error类型,我们可以通过调用error的Error函数或者输出函数获得字符串类型的错误信息。
fmt.Println(err)
fmt.Printf("%v", err)通常,当函数返回non-nil的error时,其他的返回值是未定义的(undefined),这些未定义的返回值应该被忽略。然而,有少部分函数在发生错误时,仍然会返回一些有用的返回值。比如,当读取文件发生错误时,Read函数会返回可以读取的字节数以及错误信息。对于这种情况,正确的处理方式应该是先处理这些不完整的数据,再处理错误。因此对函数的返回值要有清晰的说明,以便于其他人使用。
在Go中,函数运行失败时会返回错误信息,这些错误信息被认为是一种预期的值而非异常(exception),这使得Go有别于那些将函数运行失败看作是异常的语言。虽然Go有各种异常机制,但这些机制仅被使用在处理那些未被预料到的错误,即bug,而不是那些在健壮程序中应该被避免的程序错误。对于Go的异常机制我们将在5.9介绍。
Go这样设计的原因是由于对于某个应该在控制流程中处理的错误而言,将这个错误以异常的形式抛出会混乱对错误的描述,这通常会导致一些糟糕的后果。当某个程序错误被当作异常处理后,这个错误会将堆栈跟踪信息返回给终端用户,这些信息复杂且无用,无法帮助定位错误。
正因此,Go使用控制流机制(如if和return)处理错误,这使得编码人员能更多的关注错误处理。
5.4.1. 错误处理策略
当一次函数调用返回错误时,调用者应该选择合适的方式处理错误。根据情况的不同,有很多处理方式,让我们来看看常用的五种方式。
首先,也是最常用的方式是传播错误。这意味着函数中某个子程序的失败,会变成该函数的失败。下面,我们以5.3节的findLinks函数作为例子。如果findLinks对http.Get的调用失败,findLinks会直接将这个HTTP错误返回给调用者:
resp, err := http.Get(url)
if err != nil{
return nil, err
}当对html.Parse的调用失败时,findLinks不会直接返回html.Parse的错误,因为缺少两条重要信息:1、发生错误时的解析器(html parser);2、发生错误的url。因此,findLinks构造了一个新的错误信息,既包含了这两项,也包括了底层的解析出错的信息。
doc, err := html.Parse(resp.Body)
resp.Body.Close()
if err != nil {
return nil, fmt.Errorf("parsing %s as HTML: %v", url,err)
}fmt.Errorf函数使用fmt.Sprintf格式化错误信息并返回。我们使用该函数添加额外的前缀上下文信息到原始错误信息。当错误最终由main函数处理时,错误信息应提供清晰的从原因到后果的因果链,就像美国宇航局事故调查时做的那样:
genesis: crashed: no parachute: G-switch failed: bad relay orientation由于错误信息经常是以链式组合在一起的,所以错误信息中应避免大写和换行符。最终的错误信息可能很长,我们可以通过类似grep的工具处理错误信息(译者注:grep是一种文本搜索工具)。
编写错误信息时,我们要确保错误信息对问题细节的描述是详尽的。尤其是要注意错误信息表达的一致性,即相同的函数或同包内的同一组函数返回的错误在构成和处理方式上是相似的。
以os包为例,os包确保文件操作(如os.Open、Read、Write、Close)返回的每个错误的描述不仅仅包含错误的原因(如无权限,文件目录不存在)也包含文件名,这样调用者在构造新的错误信息时无需再添加这些信息。
一般而言,被调用函数f(x)会将调用信息和参数信息作为发生错误时的上下文放在错误信息中并返回给调用者,调用者需要添加一些错误信息中不包含的信息,比如添加url到html.Parse返回的错误中。
让我们来看看处理错误的第二种策略。如果错误的发生是偶然性的,或由不可预知的问题导致的。一个明智的选择是重新尝试失败的操作。在重试时,我们需要限制重试的时间间隔或重试的次数,防止无限制的重试。
// WaitForServer attempts to contact the server of a URL.
// It tries for one minute using exponential back-off.
// It reports an error if all attempts fail.
func WaitForServer(url string) error {
const timeout = 1 * time.Minute
deadline := time.Now().Add(timeout)
for tries := 0; time.Now().Before(deadline); tries++ {
_, err := http.Head(url)
if err == nil {
return nil // success
}
log.Printf("server not responding (%s);retrying…", err)
time.Sleep(time.Second << uint(tries)) // exponential back-off
}
return fmt.Errorf("server %s failed to respond after %s", url, timeout)
}如果错误发生后,程序无法继续运行,我们就可以采用第三种策略:输出错误信息并结束程序。需要注意的是,这种策略只应在main中执行。对库函数而言,应仅向上传播错误,除非该错误意味着程序内部包含不一致性,即遇到了bug,才能在库函数中结束程序。
// (In function main.)
if err := WaitForServer(url); err != nil {
fmt.Fprintf(os.Stderr, "Site is down: %v\n", err)
os.Exit(1)
}调用log.Fatalf可以更简洁的代码达到与上文相同的效果。log中的所有函数,都默认会在错误信息之前输出时间信息。
if err := WaitForServer(url); err != nil {
log.Fatalf("Site is down: %v\n", err)
}长时间运行的服务器常采用默认的时间格式,而交互式工具很少采用包含如此多信息的格式。
2006/01/02 15:04:05 Site is down: no such domain:
bad.gopl.io我们可以设置log的前缀信息屏蔽时间信息,一般而言,前缀信息会被设置成命令名。
log.SetPrefix("wait: ")
log.SetFlags(0)第四种策略:有时,我们只需要输出错误信息就足够了,不需要中断程序的运行。我们可以通过log包提供函数
if err := Ping(); err != nil {
log.Printf("ping failed: %v; networking disabled",err)
}或者标准错误流输出错误信息。
if err := Ping(); err != nil {
fmt.Fprintf(os.Stderr, "ping failed: %v; networking disabled\n", err)
}log包中的所有函数会为没有换行符的字符串增加换行符。
第五种,也是最后一种策略:我们可以直接忽略掉错误。
dir, err := ioutil.TempDir("", "scratch")
if err != nil {
return fmt.Errorf("failed to create temp dir: %v",err)
}
// ...use temp dir…
os.RemoveAll(dir) // ignore errors; $TMPDIR is cleaned periodically尽管os.RemoveAll会失败,但上面的例子并没有做错误处理。这是因为操作系统会定期的清理临时目录。正因如此,虽然程序没有处理错误,但程序的逻辑不会因此受到影响。我们应该在每次函数调用后,都养成考虑错误处理的习惯,当你决定忽略某个错误时,你应该清晰地写下你的意图。
在Go中,错误处理有一套独特的编码风格。检查某个子函数是否失败后,我们通常将处理失败的逻辑代码放在处理成功的代码之前。如果某个错误会导致函数返回,那么成功时的逻辑代码不应放在else语句块中,而应直接放在函数体中。Go中大部分函数的代码结构几乎相同,首先是一系列的初始检查,防止错误发生,之后是函数的实际逻辑。
5.4.2. 文件结尾错误(EOF)
函数经常会返回多种错误,这对终端用户来说可能会很有趣,但对程序而言,这使得情况变得复杂。很多时候,程序必须根据错误类型,作出不同的响应。让我们考虑这样一个例子:从文件中读取n个字节。如果n等于文件的长度,读取过程的任何错误都表示失败。如果n小于文件的长度,调用者会重复的读取固定大小的数据直到文件结束。这会导致调用者必须分别处理由文件结束引起的各种错误。基于这样的原因,io包保证任何由文件结束引起的读取失败都返回同一个错误——io.EOF,该错误在io包中定义:
package io
import "errors"
// EOF is the error returned by Read when no more input is available.
var EOF = errors.New("EOF")调用者只需通过简单的比较,就可以检测出这个错误。下面的例子展示了如何从标准输入中读取字符,以及判断文件结束。(4.3的chartcount程序展示了更加复杂的代码)
in := bufio.NewReader(os.Stdin)
for {
r, _, err := in.ReadRune()
if err == io.EOF {
break // finished reading
}
if err != nil {
return fmt.Errorf("read failed:%v", err)
}
// ...use r…
}因为文件结束这种错误不需要更多的描述,所以io.EOF有固定的错误信息——“EOF”。对于其他错误,我们可能需要在错误信息中描述错误的类型和数量,这使得我们不能像io.EOF一样采用固定的错误信息。在7.11节中,我们会提出更系统的方法区分某些固定的错误值。
5.5. 函数值
在Go中,函数被看作第一类值(first-class values):函数像其他值一样,拥有类型,可以被赋值给其他变量,传递给函数,从函数返回。对函数值(function value)的调用类似函数调用。例子如下:
func square(n int) int { return n * n }
func negative(n int) int { return -n }
func product(m, n int) int { return m * n }
f := square
fmt.Println(f(3)) // "9"
f = negative
fmt.Println(f(3)) // "-3"
fmt.Printf("%T\n", f) // "func(int) int"
f = product // compile error: can't assign func(int, int) int to func(int) int函数类型的零值是nil。调用值为nil的函数值会引起panic错误:
var f func(int) int
f(3) // 此处f的值为nil, 会引起panic错误函数值可以与nil比较:
var f func(int) int
if f != nil {
f(3)
}但是函数值之间是不可比较的,也不能用函数值作为map的key。
函数值使得我们不仅仅可以通过数据来参数化函数,亦可通过行为。标准库中包含许多这样的例子。下面的代码展示了如何使用这个技巧。strings.Map对字符串中的每个字符调用add1函数,并将每个add1函数的返回值组成一个新的字符串返回给调用者。
func add1(r rune) rune { return r + 1 }
fmt.Println(strings.Map(add1, "HAL-9000")) // "IBM.:111"
fmt.Println(strings.Map(add1, "VMS")) // "WNT"
fmt.Println(strings.Map(add1, "Admix")) // "Benjy"5.2节的findLinks函数使用了辅助函数visit,遍历和操作了HTML页面的所有结点。使用函数值,我们可以将遍历结点的逻辑和操作结点的逻辑分离,使得我们可以复用遍历的逻辑,从而对结点进行不同的操作。
// forEachNode针对每个结点x,都会调用pre(x)和post(x)。
// pre和post都是可选的。
// 遍历孩子结点之前,pre被调用
// 遍历孩子结点之后,post被调用
func forEachNode(n *html.Node, pre, post func(n *html.Node)) {
if pre != nil {
pre(n)
}
for c := n.FirstChild; c != nil; c = c.NextSibling {
forEachNode(c, pre, post)
}
if post != nil {
post(n)
}
}该函数接收2个函数作为参数,分别在结点的孩子被访问前和访问后调用。这样的设计给调用者更大的灵活性。举个例子,现在我们有startElement和endElement两个函数用于输出HTML元素的开始标签和结束标签<b>...</b>:
var depth int
func startElement(n *html.Node) {
if n.Type == html.ElementNode {
fmt.Printf("%*s<%s>\n", depth*2, "", n.Data)
depth++
}
}
func endElement(n *html.Node) {
if n.Type == html.ElementNode {
depth--
fmt.Printf("%*s</%s>\n", depth*2, "", n.Data)
}
}上面的代码利用fmt.Printf的一个小技巧控制输出的缩进。%*s中的*会在字符串之前填充一些空格。在例子中,每次输出会先填充depth*2数量的空格,再输出"",最后再输出HTML标签。
如果我们像下面这样调用forEachNode:
forEachNode(doc, startElement, endElement)与之前的outline程序相比,我们得到了更加详细的页面结构:
$ go build gopl.io/ch5/outline2
$ ./outline2 http://gopl.io
<html>
<head>
<meta>
</meta>
<title>
</title>
<style>
</style>
</head>
<body>
<table>
<tbody>
<tr>
<td>
<a>
<img>
</img>
...5.6. 匿名函数
拥有函数名的函数只能在包级语法块中被声明,通过函数字面量(function literal),我们可绕过这一限制,在任何表达式中表示一个函数值。函数字面量的语法和函数声明相似,区别在于func关键字后没有函数名。函数值字面量是一种表达式,它的值被称为匿名函数(anonymous function)。
函数字面量允许我们在使用函数时,再定义它。通过这种技巧,我们可以改写之前对strings.Map的调用:
strings.Map(func(r rune) rune { return r + 1 }, "HAL-9000")更为重要的是,通过这种方式定义的函数可以访问完整的词法环境(lexical environment),这意味着在函数中定义的内部函数可以引用该函数的变量,如下例所示:
// squares返回一个匿名函数。
// 该匿名函数每次被调用时都会返回下一个数的平方。
func squares() func() int {
var x int
return func() int {
x++
return x * x
}
}
func main() {
f := squares()
fmt.Println(f()) // "1"
fmt.Println(f()) // "4"
fmt.Println(f()) // "9"
fmt.Println(f()) // "16"
}函数squares返回另一个类型为 func() int 的函数。对squares的一次调用会生成一个局部变量x并返回一个匿名函数。每次调用匿名函数时,该函数都会先使x的值加1,再返回x的平方。第二次调用squares时,会生成第二个x变量,并返回一个新的匿名函数。新匿名函数操作的是第二个x变量。
squares的例子证明,函数值不仅仅是一串代码,还记录了状态。在squares中定义的匿名内部函数可以访问和更新squares中的局部变量,这意味着匿名函数和squares中,存在变量引用。这就是函数值属于引用类型和函数值不可比较的原因。Go使用闭包(closures)技术实现函数值,Go程序员也把函数值叫做闭包。
通过这个例子,我们看到变量的生命周期不由它的作用域决定:squares返回后,变量x仍然隐式的存在于f中。
接下来,我们讨论一个有点学术性的例子,考虑这样一个问题:给定一些计算机课程,每个课程都有前置课程,只有完成了前置课程才可以开始当前课程的学习;我们的目标是选择出一组课程,这组课程必须确保按顺序学习时,能全部被完成。每个课程的前置课程如下:
// prereqs记录了每个课程的前置课程
var prereqs = map[string][]string{
"algorithms": {"data structures"},
"calculus": {"linear algebra"},
"compilers": {
"data structures",
"formal languages",
"computer organization",
},
"data structures": {"discrete math"},
"databases": {"data structures"},
"discrete math": {"intro to programming"},
"formal languages": {"discrete math"},
"networks": {"operating systems"},
"operating systems": {"data structures", "computer organization"},
"programming languages": {"data structures", "computer organization"},
}这类问题被称作拓扑排序。从概念上说,前置条件可以构成有向图。图中的顶点表示课程,边表示课程间的依赖关系。显然,图中应该无环,这也就是说从某点出发的边,最终不会回到该点。下面的代码用深度优先搜索了整张图,获得了符合要求的课程序列。
func main() {
for i, course := range topoSort(prereqs) {
fmt.Printf("%d:\t%s\n", i+1, course)
}
}
func topoSort(m map[string][]string) []string {
var order []string
seen := make(map[string]bool)
var visitAll func(items []string)
visitAll = func(items []string) {
for _, item := range items {
if !seen[item] {
seen[item] = true
visitAll(m[item])
order = append(order, item)
}
}
}
var keys []string
for key := range m {
keys = append(keys, key)
}
sort.Strings(keys)
visitAll(keys)
return order
}当匿名函数需要被递归调用时,我们必须首先声明一个变量(在上面的例子中,我们首先声明了 visitAll),再将匿名函数赋值给这个变量。如果不分成两步,函数字面量无法与visitAll绑定,我们也无法递归调用该匿名函数。
visitAll := func(items []string) {
// ...
visitAll(m[item]) // compile error: undefined: visitAll
// ...
}在toposort程序的输出如下所示,它的输出顺序是大多人想看到的固定顺序输出,但是这需要我们多花点心思才能做到。哈希表prepreqs的value是遍历顺序固定的切片,而不再试遍历顺序随机的map,所以我们对prereqs的key值进行排序,保证每次运行toposort程序,都以相同的遍历顺序遍历prereqs。
1: intro to programming
2: discrete math
3: data structures
4: algorithms
5: linear algebra
6: calculus
7: formal languages
8: computer organization
9: compilers
10: databases
11: operating systems
12: networks
13: programming languages让我们回到findLinks这个例子。我们将代码移动到了links包下,将函数重命名为Extract,在第八章我们会再次用到这个函数。新的匿名函数被引入,用于替换原来的visit函数。该匿名函数负责将新连接添加到切片中。在Extract中,使用forEachNode遍历HTML页面,由于Extract只需要在遍历结点前操作结点,所以forEachNode的post参数被传入nil。
// Package links provides a link-extraction function.
package links
import (
"fmt"
"net/http"
"golang.org/x/net/html"
)
// Extract makes an HTTP GET request to the specified URL, parses
// the response as HTML, and returns the links in the HTML document.
func Extract(url string) ([]string, error) {
resp, err := http.Get(url)
if err != nil {
return nil, err
}
if resp.StatusCode != http.StatusOK {
resp.Body.Close()
return nil, fmt.Errorf("getting %s: %s", url, resp.Status)
}
doc, err := html.Parse(resp.Body)
resp.Body.Close()
if err != nil {
return nil, fmt.Errorf("parsing %s as HTML: %v", url, err)
}
var links []string
visitNode := func(n *html.Node) {
if n.Type == html.ElementNode && n.Data == "a" {
for _, a := range n.Attr {
if a.Key != "href" {
continue
}
link, err := resp.Request.URL.Parse(a.Val)
if err != nil {
continue // ignore bad URLs
}
links = append(links, link.String())
}
}
}
forEachNode(doc, visitNode, nil)
return links, nil
}上面的代码对之前的版本做了改进,现在links中存储的不是href属性的原始值,而是通过resp.Request.URL解析后的值。解析后,这些连接以绝对路径的形式存在,可以直接被http.Get访问。
网页抓取的核心问题就是如何遍历图。在topoSort的例子中,已经展示了深度优先遍历,在网页抓取中,我们会展示如何用广度优先遍历图。在第8章,我们会介绍如何将深度优先和广度优先结合使用。
下面的函数实现了广度优先算法。调用者需要输入一个初始的待访问列表和一个函数f。待访问列表中的每个元素被定义为string类型。广度优先算法会为每个元素调用一次f。每次f执行完毕后,会返回一组待访问元素。这些元素会被加入到待访问列表中。当待访问列表中的所有元素都被访问后,breadthFirst函数运行结束。为了避免同一个元素被访问两次,代码中维护了一个map。
// breadthFirst calls f for each item in the worklist.
// Any items returned by f are added to the worklist.
// f is called at most once for each item.
func breadthFirst(f func(item string) []string, worklist []string) {
seen := make(map[string]bool)
for len(worklist) > 0 {
items := worklist
worklist = nil
for _, item := range items {
if !seen[item] {
seen[item] = true
worklist = append(worklist, f(item)...)
}
}
}
}就像我们在章节3解释的那样,append的参数“f(item)...”,会将f返回的一组元素一个个添加到worklist中。
在我们网页抓取器中,元素的类型是url。crawl函数会将URL输出,提取其中的新链接,并将这些新链接返回。我们会将crawl作为参数传递给breadthFirst。
func crawl(url string) []string {
fmt.Println(url)
list, err := links.Extract(url)
if err != nil {
log.Print(err)
}
return list
}为了使抓取器开始运行,我们用命令行输入的参数作为初始的待访问url。
func main() {
// Crawl the web breadth-first,
// starting from the command-line arguments.
breadthFirst(crawl, os.Args[1:])
}让我们从 https://golang.org 开始,下面是程序的输出结果:
$ go build gopl.io/ch5/findlinks3
$ ./findlinks3 https://golang.org
https://golang.org/
https://golang.org/doc/
https://golang.org/pkg/
https://golang.org/project/
https://code.google.com/p/go-tour/
https://golang.org/doc/code.html
https://www.youtube.com/watch?v=XCsL89YtqCs
http://research.swtch.com/gotour当所有发现的链接都已经被访问或电脑的内存耗尽时,程序运行结束。
5.6.1. 警告:捕获迭代变量
本节,将介绍Go词法作用域的一个陷阱。请务必仔细的阅读,弄清楚发生问题的原因。即使是经验丰富的程序员也会在这个问题上犯错误。
考虑这样一个问题:你被要求首先创建一些目录,再将目录删除。在下面的例子中我们用函数值来完成删除操作。下面的示例代码需要引入os包。为了使代码简单,我们忽略了所有的异常处理。
var rmdirs []func()
for _, d := range tempDirs() {
dir := d // NOTE: necessary!
os.MkdirAll(dir, 0755) // creates parent directories too
rmdirs = append(rmdirs, func() {
os.RemoveAll(dir)
})
}
// ...do some work…
for _, rmdir := range rmdirs {
rmdir() // clean up
}你可能会感到困惑,为什么要在循环体中用循环变量d赋值一个新的局部变量,而不是像下面的代码一样直接使用循环变量dir。需要注意,下面的代码是错误的。
var rmdirs []func()
for _, dir := range tempDirs() {
os.MkdirAll(dir, 0755)
rmdirs = append(rmdirs, func() {
os.RemoveAll(dir) // NOTE: incorrect!
})
}问题的原因在于循环变量的作用域。在上面的程序中,for循环语句引入了新的词法块,循环变量dir在这个词法块中被声明。在该循环中生成的所有函数值都共享相同的循环变量。需要注意,函数值中记录的是循环变量的内存地址,而不是循环变量某一时刻的值。以dir为例,后续的迭代会不断更新dir的值,当删除操作执行时,for循环已完成,dir中存储的值等于最后一次迭代的值。这意味着,每次对os.RemoveAll的调用删除的都是相同的目录。
通常,为了解决这个问题,我们会引入一个与循环变量同名的局部变量,作为循环变量的副本。比如下面的变量dir,虽然这看起来很奇怪,但却很有用。
for _, dir := range tempDirs() {
dir := dir // declares inner dir, initialized to outer dir
// ...
}这个问题不仅存在基于range的循环,在下面的例子中,对循环变量i的使用也存在同样的问题:
var rmdirs []func()
dirs := tempDirs()
for i := 0; i < len(dirs); i++ {
os.MkdirAll(dirs[i], 0755) // OK
rmdirs = append(rmdirs, func() {
os.RemoveAll(dirs[i]) // NOTE: incorrect!
})
}如果你使用go语句(第八章)或者defer语句(5.8节)会经常遇到此类问题。这不是go或defer本身导致的,而是因为它们都会等待循环结束后,再执行函数值。
5.7. 可变参数
参数数量可变的函数称为可变参数函数。典型的例子就是fmt.Printf和类似函数。Printf首先接收一个必备的参数,之后接收任意个数的后续参数。
在声明可变参数函数时,需要在参数列表的最后一个参数类型之前加上省略符号“...”,这表示该函数会接收任意数量的该类型参数。
func sum(vals ...int) int {
total := 0
for _, val := range vals {
total += val
}
return total
}sum函数返回任意个int型参数的和。在函数体中,vals被看作是类型为[] int的切片。sum可以接收任意数量的int型参数:
fmt.Println(sum()) // "0"
fmt.Println(sum(3)) // "3"
fmt.Println(sum(1, 2, 3, 4)) // "10"在上面的代码中,调用者隐式的创建一个数组,并将原始参数复制到数组中,再把数组的一个切片作为参数传给被调用函数。如果原始参数已经是切片类型,我们该如何传递给sum?只需在最后一个参数后加上省略符。下面的代码功能与上个例子中最后一条语句相同。
values := []int{1, 2, 3, 4}
fmt.Println(sum(values...)) // "10"虽然在可变参数函数内部,...int 型参数的行为看起来很像切片类型,但实际上,可变参数函数和以切片作为参数的函数是不同的。
func f(...int) {}
func g([]int) {}
fmt.Printf("%T\n", f) // "func(...int)"
fmt.Printf("%T\n", g) // "func([]int)"可变参数函数经常被用于格式化字符串。下面的errorf函数构造了一个以行号开头的,经过格式化的错误信息。函数名的后缀f是一种通用的命名规范,代表该可变参数函数可以接收Printf风格的格式化字符串。
func errorf(linenum int, format string, args ...interface{}) {
fmt.Fprintf(os.Stderr, "Line %d: ", linenum)
fmt.Fprintf(os.Stderr, format, args...)
fmt.Fprintln(os.Stderr)
}
linenum, name := 12, "count"
errorf(linenum, "undefined: %s", name) // "Line 12: undefined: count"interface{}表示函数的最后一个参数可以接收任意类型,我们会在第7章详细介绍。
5.8. Deferred函数
在findLinks的例子中,我们用http.Get的输出作为html.Parse的输入。只有url的内容的确是HTML格式的,html.Parse才可以正常工作,但实际上,url指向的内容很丰富,可能是图片,纯文本或是其他。将这些格式的内容传递给html.parse,会产生不良后果。
下面的例子获取HTML页面并输出页面的标题。title函数会检查服务器返回的Content-Type字段,如果发现页面不是HTML,将终止函数运行,返回错误。
func title(url string) error {
resp, err := http.Get(url)
if err != nil {
return err
}
// Check Content-Type is HTML (e.g., "text/html;charset=utf-8").
ct := resp.Header.Get("Content-Type")
if ct != "text/html" && !strings.HasPrefix(ct,"text/html;") {
resp.Body.Close()
return fmt.Errorf("%s has type %s, not text/html",url, ct)
}
doc, err := html.Parse(resp.Body)
resp.Body.Close()
if err != nil {
return fmt.Errorf("parsing %s as HTML: %v", url,err)
}
visitNode := func(n *html.Node) {
if n.Type == html.ElementNode && n.Data == "title"&&n.FirstChild != nil {
fmt.Println(n.FirstChild.Data)
}
}
forEachNode(doc, visitNode, nil)
return nil
}下面展示了运行效果:
$ go build gopl.io/ch5/title1
$ ./title1 http://gopl.io
The Go Programming Language
$ ./title1 https://golang.org/doc/effective_go.html
Effective Go - The Go Programming Language
$ ./title1 https://golang.org/doc/gopher/frontpage.png
title1: https://golang.org/doc/gopher/frontpage.png has type image/png, not text/htmlresp.Body.close调用了多次,这是为了确保title在所有执行路径下(即使函数运行失败)都关闭了网络连接。随着函数变得复杂,需要处理的错误也变多,维护清理逻辑变得越来越困难。而Go语言独有的defer机制可以让事情变得简单。
你只需要在调用普通函数或方法前加上关键字defer,就完成了defer所需要的语法。当执行到该条语句时,函数和参数表达式得到计算,但直到包含该defer语句的函数执行完毕时,defer后的函数才会被执行,不论包含defer语句的函数是通过return正常结束,还是由于panic导致的异常结束。你可以在一个函数中执行多条defer语句,它们的执行顺序与声明顺序相反。
defer语句经常被用于处理成对的操作,如打开、关闭、连接、断开连接、加锁、释放锁。通过defer机制,不论函数逻辑多复杂,都能保证在任何执行路径下,资源被释放。释放资源的defer应该直接跟在请求资源的语句后。在下面的代码中,一条defer语句替代了之前的所有resp.Body.Close
func title(url string) error {
resp, err := http.Get(url)
if err != nil {
return err
}
defer resp.Body.Close()
ct := resp.Header.Get("Content-Type")
if ct != "text/html" && !strings.HasPrefix(ct,"text/html;") {
return fmt.Errorf("%s has type %s, not text/html",url, ct)
}
doc, err := html.Parse(resp.Body)
if err != nil {
return fmt.Errorf("parsing %s as HTML: %v", url,err)
}
// ...print doc's title element…
return nil
}在处理其他资源时,也可以采用defer机制,比如对文件的操作:
io/ioutil
package ioutil
func ReadFile(filename string) ([]byte, error) {
f, err := os.Open(filename)
if err != nil {
return nil, err
}
defer f.Close()
return ReadAll(f)
}或是处理互斥锁(9.2章)
var mu sync.Mutex
var m = make(map[string]int)
func lookup(key string) int {
mu.Lock()
defer mu.Unlock()
return m[key]
}调试复杂程序时,defer机制也常被用于记录何时进入和退出函数。下例中的bigSlowOperation函数,直接调用trace记录函数的被调情况。bigSlowOperation被调时,trace会返回一个函数值,该函数值会在bigSlowOperation退出时被调用。通过这种方式, 我们可以只通过一条语句控制函数的入口和所有的出口,甚至可以记录函数的运行时间,如例子中的start。需要注意一点:不要忘记defer语句后的圆括号,否则本该在进入时执行的操作会在退出时执行,而本该在退出时执行的,永远不会被执行。
func bigSlowOperation() {
defer trace("bigSlowOperation")() // don't forget the extra parentheses
// ...lots of work…
time.Sleep(10 * time.Second) // simulate slow operation by sleeping
}
func trace(msg string) func() {
start := time.Now()
log.Printf("enter %s", msg)
return func() {
log.Printf("exit %s (%s)", msg,time.Since(start))
}
}每一次bigSlowOperation被调用,程序都会记录函数的进入,退出,持续时间。(我们用time.Sleep模拟一个耗时的操作)
$ go build gopl.io/ch5/trace
$ ./trace
2015/11/18 09:53:26 enter bigSlowOperation
2015/11/18 09:53:36 exit bigSlowOperation (10.000589217s)我们知道,defer语句中的函数会在return语句更新返回值变量后再执行,又因为在函数中定义的匿名函数可以访问该函数包括返回值变量在内的所有变量,所以,对匿名函数采用defer机制,可以使其观察函数的返回值。
以double函数为例:
func double(x int) int {
return x + x
}我们只需要首先命名double的返回值,再增加defer语句,我们就可以在double每次被调用时,输出参数以及返回值。
func double(x int) (result int) {
defer func() { fmt.Printf("double(%d) = %d\n", x,result) }()
return x + x
}
_ = double(4)
// Output:
// "double(4) = 8"可能double函数过于简单,看不出这个小技巧的作用,但对于有许多return语句的函数而言,这个技巧很有用。
被延迟执行的匿名函数甚至可以修改函数返回给调用者的返回值:
func triple(x int) (result int) {
defer func() { result += x }()
return double(x)
}
fmt.Println(triple(4)) // "12"在循环体中的defer语句需要特别注意,因为只有在函数执行完毕后,这些被延迟的函数才会执行。下面的代码会导致系统的文件描述符耗尽,因为在所有文件都被处理之前,没有文件会被关闭。
for _, filename := range filenames {
f, err := os.Open(filename)
if err != nil {
return err
}
defer f.Close() // NOTE: risky; could run out of file descriptors
// ...process f…
}一种解决方法是将循环体中的defer语句移至另外一个函数。在每次循环时,调用这个函数。
for _, filename := range filenames {
if err := doFile(filename); err != nil {
return err
}
}
func doFile(filename string) error {
f, err := os.Open(filename)
if err != nil {
return err
}
defer f.Close()
// ...process f…
}下面的代码是fetch(1.5节)的改进版,我们将http响应信息写入本地文件而不是从标准输出流输出。我们通过path.Base提出url路径的最后一段作为文件名。
// Fetch downloads the URL and returns the
// name and length of the local file.
func fetch(url string) (filename string, n int64, err error) {
resp, err := http.Get(url)
if err != nil {
return "", 0, err
}
defer resp.Body.Close()
local := path.Base(resp.Request.URL.Path)
if local == "/" {
local = "index.html"
}
f, err := os.Create(local)
if err != nil {
return "", 0, err
}
n, err = io.Copy(f, resp.Body)
// Close file, but prefer error from Copy, if any.
if closeErr := f.Close(); err == nil {
err = closeErr
}
return local, n, err
}对resp.Body.Close延迟调用我们已经见过了,在此不做解释。上例中,通过os.Create打开文件进行写入,在关闭文件时,我们没有对f.close采用defer机制,因为这会产生一些微妙的错误。许多文件系统,尤其是NFS,写入文件时发生的错误会被延迟到文件关闭时反馈。如果没有检查文件关闭时的反馈信息,可能会导致数据丢失,而我们还误以为写入操作成功。如果io.Copy和f.close都失败了,我们倾向于将io.Copy的错误信息反馈给调用者,因为它先于f.close发生,更有可能接近问题的本质。
5.9. Panic异常
Go的类型系统会在编译时捕获很多错误,但有些错误只能在运行时检查,如数组访问越界、空指针引用等。这些运行时错误会引起panic异常。
一般而言,当panic异常发生时,程序会中断运行,并立即执行在该goroutine(可以先理解成线程,在第8章会详细介绍)中被延迟的函数(defer 机制)。随后,程序崩溃并输出日志信息。日志信息包括panic value和函数调用的堆栈跟踪信息。panic value通常是某种错误信息。对于每个goroutine,日志信息中都会有与之相对的,发生panic时的函数调用堆栈跟踪信息。通常,我们不需要再次运行程序去定位问题,日志信息已经提供了足够的诊断依据。因此,在我们填写问题报告时,一般会将panic异常和日志信息一并记录。
不是所有的panic异常都来自运行时,直接调用内置的panic函数也会引发panic异常;panic函数接受任何值作为参数。当某些不应该发生的场景发生时,我们就应该调用panic。比如,当程序到达了某条逻辑上不可能到达的路径:
switch s := suit(drawCard()); s {
case "Spades": // ...
case "Hearts": // ...
case "Diamonds": // ...
case "Clubs": // ...
default:
panic(fmt.Sprintf("invalid suit %q", s)) // Joker?
}断言函数必须满足的前置条件是明智的做法,但这很容易被滥用。除非你能提供更多的错误信息,或者能更快速的发现错误,否则不需要断言那些运行时会检查的条件。
func Reset(x *Buffer) {
if x == nil {
panic("x is nil") // unnecessary!
}
x.elements = nil
}虽然Go的panic机制类似于其他语言的异常,但panic的适用场景有一些不同。由于panic会引起程序的崩溃,因此panic一般用于严重错误,如程序内部的逻辑不一致。勤奋的程序员认为任何崩溃都表明代码中存在漏洞,所以对于大部分漏洞,我们应该使用Go提供的错误机制,而不是panic,尽量避免程序的崩溃。在健壮的程序中,任何可以预料到的错误,如不正确的输入、错误的配置或是失败的I/O操作都应该被优雅的处理,最好的处理方式,就是使用Go的错误机制。
考虑regexp.Compile函数,该函数将正则表达式编译成有效的可匹配格式。当输入的正则表达式不合法时,该函数会返回一个错误。当调用者明确的知道正确的输入不会引起函数错误时,要求调用者检查这个错误是不必要和累赘的。我们应该假设函数的输入一直合法,就如前面的断言一样:当调用者输入了不应该出现的输入时,触发panic异常。
在程序源码中,大多数正则表达式是字符串字面值(string literals),因此regexp包提供了包装函数regexp.MustCompile检查输入的合法性。
package regexp
func Compile(expr string) (*Regexp, error) { /* ... */ }
func MustCompile(expr string) *Regexp {
re, err := Compile(expr)
if err != nil {
panic(err)
}
return re
}包装函数使得调用者可以便捷的用一个编译后的正则表达式为包级别的变量赋值:
var httpSchemeRE = regexp.MustCompile(`^https?:`) //"http:" or "https:"显然,MustCompile不能接收不合法的输入。函数名中的Must前缀是一种针对此类函数的命名约定,比如template.Must(4.6节)
func main() {
f(3)
}
func f(x int) {
fmt.Printf("f(%d)\n", x+0/x) // panics if x == 0
defer fmt.Printf("defer %d\n", x)
f(x - 1)
}上例中的运行输出如下:
f(3)
f(2)
f(1)
defer 1
defer 2
defer 3当f(0)被调用时,发生panic异常,之前被延迟执行的3个fmt.Printf被调用。程序中断执行后,panic信息和堆栈信息会被输出(下面是简化的输出):
panic: runtime error: integer divide by zero
main.f(0)
src/gopl.io/ch5/defer1/defer.go:14
main.f(1)
src/gopl.io/ch5/defer1/defer.go:16
main.f(2)
src/gopl.io/ch5/defer1/defer.go:16
main.f(3)
src/gopl.io/ch5/defer1/defer.go:16
main.main()
src/gopl.io/ch5/defer1/defer.go:10我们在下一节将看到,如何使程序从panic异常中恢复,阻止程序的崩溃。
为了方便诊断问题,runtime包允许程序员输出堆栈信息。在下面的例子中,我们通过在main函数中延迟调用printStack输出堆栈信息。
func main() {
defer printStack()
f(3)
}
func printStack() {
var buf [4096]byte
n := runtime.Stack(buf[:], false)
os.Stdout.Write(buf[:n])
}printStack的简化输出如下(下面只是printStack的输出,不包括panic的日志信息):
goroutine 1 [running]:
main.printStack()
src/gopl.io/ch5/defer2/defer.go:20
main.f(0)
src/gopl.io/ch5/defer2/defer.go:27
main.f(1)
src/gopl.io/ch5/defer2/defer.go:29
main.f(2)
src/gopl.io/ch5/defer2/defer.go:29
main.f(3)
src/gopl.io/ch5/defer2/defer.go:29
main.main()
src/gopl.io/ch5/defer2/defer.go:15将panic机制类比其他语言异常机制的读者可能会惊讶,runtime.Stack为何能输出已经被释放函数的信息?在Go的panic机制中,延迟函数的调用在释放堆栈信息之前。
5.10. Recover捕获异常
通常来说,不应该对panic异常做任何处理,但有时,也许我们可以从异常中恢复,至少我们可以在程序崩溃前,做一些操作。举个例子,当web服务器遇到不可预料的严重问题时,在崩溃前应该将所有的连接关闭;如果不做任何处理,会使得客户端一直处于等待状态。如果web服务器还在开发阶段,服务器甚至可以将异常信息反馈到客户端,帮助调试。
如果在deferred函数中调用了内置函数recover,并且定义该defer语句的函数发生了panic异常,recover会使程序从panic中恢复,并返回panic value。导致panic异常的函数不会继续运行,但能正常返回。在未发生panic时调用recover,recover会返回nil。
让我们以语言解析器为例,说明recover的使用场景。考虑到语言解析器的复杂性,即使某个语言解析器目前工作正常,也无法肯定它没有漏洞。因此,当某个异常出现时,我们不会选择让解析器崩溃,而是会将panic异常当作普通的解析错误,并附加额外信息提醒用户报告此错误。
func Parse(input string) (s *Syntax, err error) {
defer func() {
if p := recover(); p != nil {
err = fmt.Errorf("internal error: %v", p)
}
}()
// ...parser...
}recover函数帮助Parse从panic中恢复。在deferred函数内部,panic value被附加到错误信息中;并用err变量接收错误信息,返回给调用者。我们也可以通过调用runtime.Stack往错误信息中添加完整的堆栈调用信息。
不加区分的恢复所有的panic异常,不是可取的做法;因为在panic之后,无法保证包级变量的状态仍然和我们预期一致。比如,对数据结构的一次重要更新没有被完整完成、文件或者网络连接没有被关闭、获得的锁没有被释放。此外,如果写日志时产生的panic被不加区分的恢复,可能会导致漏洞被忽略。
虽然把对panic的处理都集中在一个包下,有助于简化对复杂和不可以预料问题的处理,但作为被广泛遵守的规范,你不应该试图去恢复其他包引起的panic。公有的API应该将函数的运行失败作为error返回,而不是panic。同样的,你也不应该恢复一个由他人开发的函数引起的panic,比如说调用者传入的回调函数,因为你无法确保这样做是安全的。
有时我们很难完全遵循规范,举个例子,net/http包中提供了一个web服务器,将收到的请求分发给用户提供的处理函数。很显然,我们不能因为某个处理函数引发的panic异常,杀掉整个进程;web服务器遇到处理函数导致的panic时会调用recover,输出堆栈信息,继续运行。这样的做法在实践中很便捷,但也会引起资源泄漏,或是因为recover操作,导致其他问题。
基于以上原因,安全的做法是有选择性的recover。换句话说,只恢复应该被恢复的panic异常,此外,这些异常所占的比例应该尽可能的低。为了标识某个panic是否应该被恢复,我们可以将panic value设置成特殊类型。在recover时对panic value进行检查,如果发现panic value是特殊类型,就将这个panic作为error处理,如果不是,则按照正常的panic进行处理(在下面的例子中,我们会看到这种方式)。
下面的例子是title函数的变形,如果HTML页面包含多个<title>,该函数会给调用者返回一个错误(error)。在soleTitle内部处理时,如果检测到有多个<title>,会调用panic,阻止函数继续递归,并将特殊类型bailout作为panic的参数。
// soleTitle returns the text of the first non-empty title element
// in doc, and an error if there was not exactly one.
func soleTitle(doc *html.Node) (title string, err error) {
type bailout struct{}
defer func() {
switch p := recover(); p {
case nil: // no panic
case bailout{}: // "expected" panic
err = fmt.Errorf("multiple title elements")
default:
panic(p) // unexpected panic; carry on panicking
}
}()
// Bail out of recursion if we find more than one nonempty title.
forEachNode(doc, func(n *html.Node) {
if n.Type == html.ElementNode && n.Data == "title" &&
n.FirstChild != nil {
if title != "" {
panic(bailout{}) // multiple titleelements
}
title = n.FirstChild.Data
}
}, nil)
if title == "" {
return "", fmt.Errorf("no title element")
}
return title, nil
}在上例中,deferred函数调用recover,并检查panic value。当panic value是bailout{}类型时,deferred函数生成一个error返回给调用者。当panic value是其他non-nil值时,表示发生了未知的panic异常,deferred函数将调用panic函数并将当前的panic value作为参数传入;此时,等同于recover没有做任何操作。(请注意:在例子中,对可预期的错误采用了panic,这违反了之前的建议,我们在此只是想向读者演示这种机制。)
有些情况下,我们无法恢复。某些致命错误会导致Go在运行时终止程序,如内存不足。